sábado, 14 de marzo de 2020

¿Está “degenerando” la calidad de las búsquedas de Google?


Creo que además del exceso de publicidad (cada vez mayor y menos diferenciado) y los problemas de confidencialidad (de los que los usuarios son cada vez más conscientes) a nivel técnico la calidad de los resultados de Google está descendiendo. Reflexiono a continuación sobre este asunto.

Un poco de historia


Lo primero que hay que recordar es que la búsqueda de documentos o páginas web por palabras no la inventó Google ni empezó en este siglo. Existen herramientas de búsqueda por contenido o texto completo desde hace más de 40 años.
Ya en los años 70 del siglo XX, productos como BRS ofrecían la posibilidad de buscar documentos por palabras de los mismos, normalmente orientados a bases de datos especializadas y bajo suscripción, aunque posteriormente BRS permitía a una empresa u organismo comprarlo y tener internamente indexados sus propios documentos.
A principios de los 90, productos como CD-Author, Personal Librarian Software, Knosys o Prodoc permitían indexar colecciones de documentos y editar CDs para publicar bases de datos de textos que permitían buscar por el contenido. Este tipo de herramientas se utilizó sobre todo en bases de datos legales que permitían buscar legislación o jurisprudencia por combinaciones de palabras contenidas en los mismos.
A mediados de los 90 empezaron a aparecer los primeros buscadores web, como WebCrawler, InfoSeek, Altavista, Yahoo! y finalmente Google.
Actualmente, además de los buscadores disponibles en Internet, existen herramientas como Lucene  (que se ha convertido en la base de muchos otros productos), Xapian, Autonomy, Inktomi  o Sphinx que permiten indexar nuestro propio contenido y publicarlo (ya sea en Internet, en Intranet o asociado a un proyecto o aplicación).
Además, han surgido los metabuscadores, que utilizan otros buscadores para lanzar las consultas, combinando los resultados, anonimizando y añadiendo otros valores.

"Search Engine Optimization seo" by James Dell is licensed under CC BY-NC 4.0


Cómo funcionan los Motores de búsqueda por contenido


Para entender qué podemos esperar y qué podemos considerar funcionamiento “correcto” o “incorrecto” es importante entender cómo funcionan los buscadores por contenido (sean en internet o no).
Utilizo la palabra documento independientemente de que se trata de una página web o de que se trate un documento por ejemplo ofimático o pdf. La operativa de búsqueda y recuperación básicamente es la misma.
Son procesos complejos que requerirían mucha extensión para describir todos los matices y operaciones, por lo que los describo a continuación de forma muy simplificada. Hay muchos artículos explicando detalladamente el funcionamiento.

Podemos hablar de dos o tres pasos  básicos:
  1. Obtener los documentos (cuando no somos los propietarios debemos “buscarlos” por internet, si somos los propietarios, debemos “insertarlos” en el buscador)
  2. La indexación de los documentos o páginas localizados.
  3. La búsqueda

Si disponemos de una colección de documentos que queremos indexar y publicar, no hay que “buscarlos”, pero un buscador público en internet sí debe buscarlos. Para ello se utilizan programas llamados “web crawlers”,  “arañas Web” o “rastreador web” que recorren páginas sistemáticamente, barriendo dominios, portales e hipervínculos, para descargar el html o documentos referenciados. Si somos los propietarios, debemos “insertarlos” en el buscador para que los procese.

En cualquier caso, el resultado de esta fase son documentos en diversos formatos (html, pdf, docx, pptx, odt,..) que deben indexarse. Lógicamente la calidad de los resultados viene determinado en primer lugar por esta fase. Si la página no se ha encontrado, nunca podrá incluirse en la indexación ni por tanto, recuperarse en las búsquedas. Esta es la primera fuente de problemas: Muchas páginas requieren autenticación o suscripción, con lo que no es posible recuperarlas, y otras están compuestas de fragmentos de página que combinan otras páginas que varían con el tiempo (por ejemplo blog, medios de comunicación o aglutinadores que incrustan otros blog, medios de comunicación o noticias). Se toma una foto de la página en un momento dado y cuando accedemos a ella al cabo de varios días, ya no está la información que buscábamos.

La siguiente fase es la más crítica en mi opinión, la indexación de los documentos. Reduciendo el proceso a lo más elemental, se trata simplemente de extraer las palabras y anotar la referencia al documento en que aparecen. Para empezar, debe ignorarse no solo el que una palabra esté en mayúsculas o minúsculas (algo sencillo), sino los acentos (ya que puede haberse omitido por error o no incluido en una palabra en mayúsculas)  y hay que tener en cuenta los códigos de página usados en el documento, que afecta a la forma en que se referencia y almacenan  que ciertos caracteres (como acentos, ñ, etc).   Tras un primer tratamiento, esto nos daría, para cada palabra, la lista de todos los documentos (o urls) en que aparece.
Pero esto sería poco eficaz, ya que, por ejemplo, no tiene sentido tratar como palabras distintas el singular o plural o los distintos tiempos de un verbo. Para ello se aplica el proceso llamado stemming  de forma lo que se maneja es la raíz de la palabra. Esto permite referenciar mejor. 
Por otra parte, hay palabras que no aportan mucho y ocupan espacio en los índices, como pueden ser artículos o preposiciones, por lo que los motores utilizan una lista de palabras vacías o stop words que se ignoran al indexar. Además, hay que sumar que muchos motores de búsqueda permiten buscar palabras “cercanas” (en el mismo párrafo o a una distancia de N palabras), lo que permite afinar más la búsqueda (lógicamente no es lo mismo que aparezcan dos palabras en el mismo párrafo que al principio y al final de un documento, especialmente si este es largo). Para ello debe guardarse la posición de la palabra dentro del documento.

Podemos seguir así iterando acerca de cómo analizar e indexar los documentos para facilitar y mejorar que luego puedan ser recuperados. El problema es que estas mejoras, que ayudan a la búsqueda en algunos casos, empiezan a perturbar la recuperación de documentos en determinados casos, por ejemplo si se quiere localizar “La Busca” de Pio Baroja, y hemos desechado “La” como palabra vacía.

Sin embargo, estos procesos, que para conjuntos de documentos pequeños pueden ser suficientes, ya que los resultados de una búsqueda serán pequeños,  no lo son cuando tratamos cientos de millones de páginas y cualquier búsqueda puede recuperar miles o cientos de miles de páginas de resultados, ya que no es eficaz que un usuario se recorra todas.
Esto nos lleva a “la madre del cordero”: ¿Cómo ordenar todos los resultados? ¿Cumplen todos los documentos los criterios de búsqueda igual? ¿Son todos igual de importantes? ¿Son todos igual de importantes para MI?.
Por ejemplo puede pensarse que si aparece más veces la palabra buscada, el documento es más “acertado”, pero, ¿y si son dos o tres palabras? ¿La suma? ¿Qué ocurre si una palabra aparece muchísimo y las otras solo una vez? ¿No podría considerarse más significativo una en que las tres aparezcan más o menos igual, aunque sumen menos apariciones totales? Esto implicaría un factor de ponderación.
Por otra parte, entre dos documentos con las mismas palabras, parece razonable considerar más “importante”  o adecuado a aquel que más páginas referencian, es decir aquel qué más personas consideran útil.
Similarmente, un documento con más referencias a otros documento podría considerarse más “fundado”  y “sólido” como para situarlo destacado.
Finalmente en este repaso MUY simplificado, lo que para una persona es importante, para otra puede no serlo. Para ello puede tenerse en cuenta los documentos que hemos elegido en anteriores búsquedas, para presentar en otras ocasiones documentos que nosotros personalmente consideramos más adecuados. Y ahí se introduce otro problema distinto, el manejo de los datos personales y las preferencias de cada uno. Esta ayuda tiene un coste, que no es objeto de este texto, ya que solo se trata de reflexionar sobre la “calidad” de los resultados, no sobre la privacidad

Puede seguir así añadiéndose criterios (¿Es “mejor” un documento nuevo o viejo?, ¿de un portal o de otro?, ¿más visitado?,..,…) para considera “mejor resultado” un documento u otro. Este algoritmo y sistema de ponderaciones y pesos es lo que en el caso de Google se ha llamado Page Rank

Page Rank [Tomwsulcer / CC0]


Y tras todos estos análisis y ponderaciones, llega el momento de buscar. Como es bien sabido, hay una sintaxis en la mayoría de los motores de búsqueda que suele ser:

  • Palabra: Devolverá todos los documentos que contiene esa palabra o derivados.
  • Varias palabra: Devolverá todos los documentos que contiene cualquiera de esas palabras.
  • palabra1 OR palabra2: Devolverá todos los documentos que contiene alguna de esas palabras.
  • "Varias palabra": Si se introduce una o varias palabras entre comillas, devolverá exclusivamente los documentos con esa expresión literal.
  • -Palabra : La palabra elegida NO puede estar en ninguno de los documentos (se eliminaran todos los que la contengan).
  • Palabra* : Incluye en la búsqueda todas las palabras que empiezan por la raíz indicada.

Algunos ejemplos


Teniendo en cuenta lo anterior, al realizar búsquedas deberíamos obtener resultados “coherentes”, pero no siempre es así.

Los ejemplos incluidos están realizado en una ventana en modo privado (para evitar que tenga en cuenta preferencias personales) y he descartado algunas búsquedas que he “sufrido” en mi día a día por confidencialidad, para no hacer propaganda de productos o por simplicidad

Como ayuda, aquí hay una referencia de los operadores de búsqueda:
y la oficial:

Supongamos que buscamos:


Si ahora indicamos que NO debe aparecer una palabra, deberían ser siempre menos (o en el peor de los casos el mismo número de resultados), sin embargo, indica que hay más:

 
¿?

Si realizamos la búsqueda:


Nos indica que hay 2.030 resultados y 7 páginas (de 10 resultados, es decir 70 resultados)
¿?


Podemos probar también: 


Si ahora queremos extenderlo e incluir otras normas que contengan cualquiera de 2 términos


 obtenemos menos resultados que solo para uno
¿?


Una búsqueda por"formato imagen tiff" devuelve 1050 resultados y  8 paginas (es decir serían 80 resultados, ¿no quedamos que 1050?)

pero cuando elegimos la página 8 aparece vacía e indica que son 7 y 62 


¿?

Por último, dada la actualidad:


 Por si no son suficientes, ampliamos:


Y obtenemos la mitad de resultados.
¿?

Sin comentarios..

Hay que tener en cuenta además que yo he realizado búsquedas y obtenido resultados muy diversos en diferentes días, devolviendo por ejemplo, unos días 58.000 regitros y otros 258.000

A todo ello hay que sumar que, independientemente de la cantidad y calidad de los resultados, desde hace meses Google no permite recorrer más allá de 15 o 18 páginas. Desconozco el motivo, no sé si para ahorrar recursos, para “no mostrar las vergüenzas” presentando resultados incorrectos que no tiene nada que ver o porque las cifras no son reales.

Sé que se dice que “nadie pasa de la segunda página”, pero además del hecho de que se encuentra información muy interesante en muchas de ellas, aunque sean menos conocidas y a veces precisamente por eso, hay trabajos, por ejemplo de investigación, que requieren exhaustividad. Además, en muchos casos el uso de estrategias de optimización SEO hace que siempre aparezcan en las primeras posiciones las que más dinero y esfuerzo invierten, independientemente de la adecuación o interés de ellas, por lo que conviene revisar varias páginas.

No he mostrado ejemplos “cualitativos”, pero en más de una ocasión, he encontrado resultados que no contenían ninguna de las palabras  (ni derivados) utilizadas para buscar.

Conclusiones


A la complejidad de manejar miles de millones de páginas actualizadas continuamente, en cientos de idiomas, hay que añadir  que las páginas utilizan estrategias SEO para potenciar su aparición y posición, que hay páginas que parecen haber incluido todo tipo de palabras para aparecer en cualquier búsqueda, da igual que se trate de “Ingeniería nuclear” o de “la cría del cangrejo”, por lo que no es una tarea fácil. 
Google sigue siendo un buen buscador y es una herramienta a no despreciar.

El objetivo de este texto es resaltar que Google no es infalible y sus resultados son discutible en muchos casos (especialmente en el aspecto cuantitativo).
En lugar de considerar a Google EL Oráculo y EL buscador, puede ser el momento de combinar y contrastar su uso con otros buscadores como DuckDuckGo o Ecosia (que dedica una parte de los beneficios de la publicidad obtenida con cada búsqueda a  plantar árboles) 


miércoles, 30 de octubre de 2019

Cloud o “cuidado con La Nube, que puede ser de tormenta”.


Uno de los temas tecnológicos “de moda“ estos últimos años es la de “Computación en la nube”  o de forma abreviada Cloud o la Nube. El problema es que con ese término se referencia en muchas ocasiones  conceptos distintos o erróneos, se mezclan aspectos técnicos con otros operativos/económicos y además se atribuye propiedades casi mágicas que van a arreglar todos los problemas tecnológicos de una entidad. Este artículo reflexiona, como es habitual de forma crítica, sobre los diferentes conceptos y hasta qué punto pueden ser una solución o un problema adicional.

Sistema VirtualBox en Windows7 ejecutando dos máquinas virtuales: Linux Mint17 y Ubuntu14.04 Gnome3. Waspteo [CC0]


Conceptos


Para empezar ¿qué quiere decir Computación en la nube?
Básicamente se trata de disponer de “servicios informáticos” (ordenadores, bases de datos, aplicaciones,..) gestionados por una empresa. Es decir, en lugar de comprar un ordenador (o un programa) me conecto a un sistema remoto que una empresa me ofrece pagando por horas, meses, uso, etc.
Pero, ¿Eso no es lo que se hacía ya hace años, antes incluso de la Burbuja de las .COM, cuando contrataba un hosting o Alojamiento Web para publicar mis páginas o mi base de datos de productos y servicios?
Si, realmente sería lo mismo (o una variante), así que lo primero que habría que aclarar es que no se acaba de descubrir ni es algo “revolucionario”, lleva utilizándose más de 20 años. E incluso si se retrocede a los albores de la informática, el alquiler de tiempo de grandes ordenadores (Mainframe) se practicaba hace ya 50 años.
No obstante el modelo se ha formalizado y ampliado, tanto tecnológicamente como comercialmente, y además la mejora de las comunicaciones y la extensión del uso de los móviles lo ha reforzado.

Suele distinguirse varios “modelos” de servicio:
  • Iaas (Infrastructure as a Service) lo que de forma muy simplificada puede traducirse como que contratamos “hardware” es decir un “ordenador”, un “disco”, “servicios de red”, etc. Es decir se dispone de “ordenadores virtuales” que configuramos según nuestras necesidades y dentro de los cuales podemos instalar los sistemas operativos que deseemos (y que debemos tener licenciados si lo requieren) y adicionalmente los programas elegidos. Esta es una posibilidad que desde hace unos 12 años ha estado disponible para instalar en ordenadores físicos en las instalaciones de cualquier empresa, utilizando programas como Virtual Box o VMWare pero que ahora se ha generalizado, permitiendo el disponer de ordenadores “remotos”.
  • PaaS (Platform as a Service) que de forma simplificada puede traducirse como que se contrata un “ordenador con software instalado” (sistema operativo, entorno Java, php, python, servidor web, base de datos, etc.). Este modelo se asimilaría al tradicional de hosting.
  • SaaS (Software as a Service) En ese modelo lo que se contrata es el uso de un software (por ejemplo: un programa de contabilidad, gestión de ventas, gestión de Centros de llamadas-Call Centre, etc...). En lugar de adquirir un software, instalarlo y gestionarlo, se contrata el uso de uno, pagando por usuarios, períodos de tiempo, etc. Y una empresa gestiona todo el sistema, dando de alta usuarios, realizando copias de seguridad, gestionando licencias, almacenamiento, etc. De forma transparente totalmente para los usuarios, que simplemente utilizan un servicio sin todas las complejidades que implica por detrás.


Además de estos tipos de servicio (cuyas fronteras no siempre son claras), hay otras criterios importantes, como pueden ser la división entre Nube Pública (Es decir servicios expuestos “a todo el mundo”, de los cuales contratamos una parte), Nube Privada (Una nube “particular” para una entidad, lo que podría asimilarse a “no alquilo un apartamento = ‘Nube Pública’ sino todo un edificio, incluyendo mi propia recepción-control de entrada”) y Nube Híbrida (Combinando elementos de Nube Pública y Nube Privada o elementos de infraestructura propia).

Sam Johnston [CC BY-SA 3.0 (https://creativecommons.org/licenses/by-sa/3.0)]
Hay un elemento importante a tener en cuenta que es ¿qué tipo de “máquina virtual” utilizo?
En estos últimos años se ha extendido un modelo de virtualización muy novedoso, la tecnología de contenedores , dentro de los cuales destaca Docker.
De forma simplificada, se trata de manejar contenedores, o “mini ordenadores” (estamos hablando en ocasiones de menos de 500M, es decir menos memoria que cualquier teléfono actual) con un “mini sistema operativo” (que suele ser el núcleo de Linux) y con una forma de trabajo en la que, en lugar de instalar el programa, se copia simplemente la máquina virtual con todo ya instalado. Si hace falta más potencia, se hacen dos copias de la máquina, etc. Como en los casos anteriores, puede utilizarse Docker sin acudir a la Nube, es decir podría utilizarse imágenes Docker dentro de nuestros propios sistemas.


Por último, hay que destacar que las principales empresas que ofrecen servicios en la Nube incluyen además servicios propietarios que solo ellos tienen (servicios de almacenamiento avanzado, de base de datos, de inteligencia artificial, etc.)


Coste


¿Cómo se cobra? Es muy variable y MUY complejo, y depende de cada proveedor. La idea general es de “pago por uso”, es decir contratamos una suscripción (bolsa económica) y podemos crear nuestra infraestructura de acuerdo a ese importe (por ejemplo la suscripción puede permitir crear dos máquinas “pequeñas” o una “grande”).
Sin embargo no es tan sencillo, porque también se puede contabilizar factores como:
    •  el tiempo que esas máquinas están funcionando
    •  la cantidad de bytes cargados o descargados
    • los bytes almacenados
    • el ancho de banda disponible para acceder o descargar
    • el número de operaciones de almacenamiento
    • El tipo/velocidad de respuesta del disco (HDD o SDD)
    • ….
Ciertos proveedores limitan alguno de esos factores, de forma que, por ejemplo, la máquina de tipo A está limitada a X capacidad simultánea u ofrecen paquetes cerrados (Ej: máquina con 4 CPU, 8G RAM y 50G de disco)
Como ejemplo, en estas direcciones pueden estudiarse las complejas tarifas de dos de los principales proveedores: Amazon  y Azure
En principio parece que por “economía de escala”, un proveedor de Nube podría ofrecer el servicio por un coste menor que el tenerlo en nuestras instalaciones, pero no hay que olvidar que estamos “alquilando” y, dependiendo de las necesidades y uso, el alquiler puede salir más rentable o menos (si no fuera así, ninguna empresa compraría camiones o furgonetas y las alquilarían siempre).


Ventajas


Como hemos visto, “casi todo” lo que puede hacerse en la Nube, puede hacerse en nuestras propias instalaciones, de forma que las principales ventajas serían:
  1. Flexibilidad: En una o dos horas puede activarse una nueva máquina, no hay que comprar hardware. Incluso aunque se disponga de un sistema interno de virtualización, normalmente estarán optimizados los recursos y no habrá mucha capacidad sobrante para crear una máquina virtual. Esto puede ser especialmente útil para realizar pruebas o cálculos puntuales, creando un gran número de máquinas para un uso puntual, que luego se liberan. Tambien puede utlizarse para una nueva empresa que no quiere invertir demasiado, o para tareas que re realizan períodicamente (procesos semanales o mensuales intensivos que requieren ordenadores que no se utilizan salvo en esos momentos).
  2. No requerir ciertos perfiles profesionales: La administración y gestión de disponibilidad de las máquinas está delegada a otra empresa, de forma que no es necesario contratar por ejemplo un profesional que no tendría trabajo todo el tiempo. No obstante esta función, en cuanto la empresa tenga cierto volumen, justifica la contratación de una persona, y en cualquier caso, siempre podría contratarse esos servicios a otra empresa para realizarlos de forma remota con los ordenadores locales sin estar en la Nube.
  3. Disponer de servicios específicos que se ofrecen únicamente en La Nube: Algunos proveedores ofrecen productos/servicios (de almacenamiento, base de datos, análisis, estadísticas, Inteligencia Artificial,..) que solo ofrecen ellos. En ese caso, más que La Nube, se trata de utilizar un servicio que no está disponible en otro ámbito.
  4. Acceso mundial: No es necesario crear una estructura de servidores y una DMZ en nuestras instalaciones para publicar ciertos servicios y servidores (por ejemplo para colaboradores, otras empresa, etc.). No obstante no hay que olvidar que esa información que se publique en La Nube, deberá sincronizarse con los servidores internos (salvo que sea información aislada y todo el trabajo y proceso se haga en esos servidores). Adicionalmente, puede obtenerse resultados similares para colaborar con empleados y otras entidades usando una VPN.
  5. Coste: En principio puede resultar rentable pagar por uso, y por ejemplo apagar ciertos servidores durante noches o fines de semana. Es un modelo de "alquiler" frente a "compra". Además, una empresa que preste este servicio tiene miles de servidores y aprovecha el tiempo en que un usuario apaga para ejecutar tareas de otro, frente a un modelo habitual en que solo presta servicio 8h o 12h.


Inconvenientes


  1. Coste: (SI, no está repetido por error, La Nube puede resultar MUY cara) En este punto ya depende mucho de los costes y economía de escala que tenga cada empresa/institución. Depende mucho de cada caso, uso y precios. Una empresa pequeña puede no requerir alguno de los servicios (soporte 24 horas, Alta disponibilidad, escalado automáticos,..) que se incluyen “automáticamente”, y puede resultarle caro. Una grande, a partir de un volumen, lo resuelve internamente con sus equipos y profesionales y puede resultarle más barato que en La Nube, por lo que tampoco le representa una ventaja. La única forma es analizar en cada escenario el coste completo (teniendo en cuenta todos los factores por supuesto)..
  2. Seguridad: Por supuesto que cualquier sistema puede ser potencialmente atacado y accedido. Pero si está públicamente disponible en Internet (y por tanto solo protegido por una clave) siempre será más inseguro que un sistema interno al que no puede accederse públicamente desde Internet.
  3. Legislación: La legislación de muchos países (incluida la Comunidad Europea) limita el manejo de datos personales, que no pueden almacenarse en cualquier lugar. Incluso en algunos países de Sudamérica, los datos y documentos no pueden salir del país. Teniendo en cuenta que para los datos almacenados en la Nube no está especificada su ubicación (o en algunos casos se especifica pero eligiendo una central “de zona” que abarca muchos países), hay muchos casos en que no es legal el uso para manejar datos personales.
  4. Integración: Salvo que tengamos TODOS los servidores en La Nube, esos servidores en La Nube deberán conectarse con nuestros servidores internos (para actualizar datos de clientes, servicios, documentación, pedidos, expedientes,…). Esa integración puede ser compleja e insegura, ya que publicamos una “puerta de entrada” al corazón de nuestros servidores.
  5. Disponer de servicios específicos que se ofrecen únicamente en La Nube: Algunos proveedores ofrecen productos/servicios (de almacenamiento, base de datos, análisis, estadísticas, Inteligencia Artificial,..) que solo ofrecen ellos.  Si, tampoco está repetido por error. Depender de un fabricante y usar un servicio que solo ofrece el significa una dependencia muy fuerte. Si el producto no va bien y se retira, o si el precio sube desorbitadamente, no hay alternativa (y si la hay implicará un desarrollo o modificaciones de los proyectos importantes, ya que son productos propietarios cuya forma de integración/invocación no suele ser estándar)


Y ¿entonces?...


Como en cualquier otra decisión, no hay respuestas absolutas, aunque sí hay algunas consideraciones a tener en cuenta antes de decidir y sobre todo delimitar el alcance de la decisión y el sentido de la decisión, para poder evaluarla correctamente.

El decidir “nuestra estrategia es el uso de La Nube” NO es una decisión tecnológica sino principalmente económica, al igual que lo sería decidir que otra empresa gestione nuestros equipos.

Si por Nube se entiende manejar máquinas virtuales ( que hace años que puede hacerse, lo raro empieza a ser no tenerlas), la decisión tecnológica sería “nuestra estrategia es virtualizar todos los ordenadores” (lo cual puede hacerse en nuestras instalaciones o en un proveedor de Nube, y la decisión será económica). En cualquier caso, serían dos decisiones:
    1- Analizar las ventajas e inconvenientes de Virtualizar (principalmente tecnológica)
    2- Analizar DONDE se hace, en nuestras instalaciones o en La Nube (principalmente económica)

Si por Nube se entiende utilizar Docker, esta SI es una decisión tecnológica muy importante, ya que la forma de desarrollar, administrar y monitorizar es muy diferente al uso de máquinas “normales” (virtualizadas o no), pero que puede llevarse a cabo igualmente “dentro” o “fuera”. Pero en ese caso la decisión es “nuestra estrategia es usar Docker para todos los proyectos”. En cualquier caso, serían dos decisiones:
    1- Analizar las ventajas e inconvenientes de usar Docker (principalmente tecnológica)
    2- Analizar DONDE se hace, en nuestras instalaciones o en La Nube (principalmente económica)

Si por Nube se entiende utilizar unos servicios concretos de un proveedor concreto, la decisión SÍ es tecnológica, pero no debe expresarse como “nuestra estrategia es el uso de La Nube” sino “nuestra estrategia es el uso de los servicios A y B del proveedor X” (habitualmente sin otras alternativas).

Una vez delimitado el sentido y alcance de la decisión, entonces realmente podremos analizar sobre los factores importantes (económicos, tecnológicos, seguridad, dependencia, nivel  de servicio, etc.) y tomar la decisión adecuada.

Por mucho que se ponga de moda, como cualquier otra tecnología, el uso de La Nube NO es la panacea, en unos casos puede ser muy útil y en otros casos un problema (y caro). Si nos acercamos corriendo a La Nube si analizarlo previamente, podemos encontrarnos con que es una Nube de tormenta...

miércoles, 12 de junio de 2019

CPDs "tuneados"


En los últimos años se está produciendo de forma exagerada lo que podríamos llamar “CPD tuneados”. Y utilizo esa expresión por comparación con esos coches que podemos encontrar por la calle, con alerones y extensiones de diverso tipo, luces por debajo y pintados con unos diseños de gusto discutible, y que sin embargo en ocasiones tienen un motor y unos amortiguadores “manifiestamente mejorables”.


"DSC01000" by carc772 is licensed under CC BY-NC-SA 2.0

De forma equivalente, nos encontramos con empresas que carecen de herramientas de gestión documental (https://pensamientocriticoti.blogspot.com/2018/02/la-maldicion-de-la-gestion-documental.html), con procesos sin automatizar con herramientas de  BPM o de Gestión de Expedientes, servidores y sistemas de bases de datos obsoletos y en general, sin los sistemas ESTRUCTURALES adecuados, pero que sin embargo están analizando cómo utilizar Blockchain,  Bigdata o Machine Learning  a pesar de que probablemente no podrán aplicarlo o no les será de utilidad ( https://pensamientocriticoti.blogspot.com/2018/03/por-que-bigdata-no-es-para-todo-el-mundo.html ) o cómo desplegar en la Nube (Cloud) aunque en ocasiones puede resultarles más costoso o incluso ilegal de acuerdo a la normativa del país.

Hace tiempo, herramientas y tecnologías aplicables a mejorar y automatizar los procesos de una empresa, y por tanto a ser más competitivos, eran objeto de análisis y selección exclusivamente del departamento de tecnología/informática/TI y el resto de los departamentos simplemente solicitaban que se mejorara o informatizara procesos o área concretas, “como fuese”, ya fuera adquiriendo equipos, desarrollando programas o comprando productos. Es decir, los usuarios indicaban qué funcionalidad querían y los técnicos buscaban cómo ofrecerla de la mejor manera posible.

Sin embargo, últimamente diversos términos y tecnologías “se han puesto de moda”, son “cool” y desde multinacionales hasta pymes solicitan a los departamentos de TI “que instalen Bigdata”, que “apliquen Machine Learning” o que se implante cualquier otra tecnología en boga.

Por supuesto, muchas de esas tecnologías pueden ser muy interesantes y reportar beneficios pero el problema es la falta de un análisis racional antes de emprender su uso. Volviendo al ejemplo de los coches ¿Tiene sentido añadir unos alerones nuevos cuando el motor no funciona bien y los amortiguadores no prestan la amortiguación adecuada? ¿No es más racional, y aportan mayor rendimiento, el mejorar y poner a punto los elementos básicos del coche en lugar de añadir anexos que aportan poco (o incluso no aportan nada)?

 Cuando la racionalidad y el rendimiento prima, por supuesto que es así; en Fórmula 1 nadie “toca un tornillo” sin exhaustivos estudios, ya que se trata de optimizar todo (consumo, resistencia, respuesta, etc.) pero esto no tiene por qué aplicar a una persona joven orgullosa de su coche, que puede desear lucirlo ante sus amistades, ya que el beneficio puede ser de imagen, no económico.


Public Domain

Sin embargo en una empresa la productividad y el rendimiento mandan, o eso debería ser. Pero el comportamiento de muchas empresas se parece más al de la persona joven que quiere lucir el coche que al del equipo de Fórmula 1 que quiere mejorar el rendimiento de un coche. Y para ello, como “queda bien”, se emprenden proyectos costosos y en muchos casos inútiles, para implantar tecnologías innecesarias o no aplicables.

Por supuesto que puede considerarse  una inversión como mejora de imagen, ya que se ofrece una visión de empresa moderna, pero en cualquier caso analizando el coste/beneficio, lo que no suele ser el caso.

A esta “orgía tecnológica” innecesaria contribuyen muchas empresas que ofrecen un futuro maravilloso y consiguen vender proyectos costosos, y en muchas ocasiones inútiles o con pocos beneficios, en base a unas expectativas irreales o excesivas (Algunos ejemplos de que "no es oro todo lo que reluce": https://medium.com/@kaistinchcombe/decentralized-and-trustless-crypto-paradise-is-actually-a-medieval-hellhole-c1ca122efdec , https://hackernoon.com/ten-years-in-nobody-has-come-up-with-a-use-case-for-blockchain-ee98c180100 , https://www.bloomberg.com/news/features/2018-03-09/bitcoin-is-ridiculous-blockchain-is-dangerous-paul-ford ).

Pero el análisis de la eficacia o no de muchas tecnologías no es el objetivo de este texto, sino la desigualdad de medios empleados en mejorar o informatizar procesos y funciones críticas de la empresa frente a los esfuerzos invertidos en elementos “decorativos”.

En ese sentido, la participación e iniciativa de los usuarios y departamentos fuera del de TI, que es muy deseable y necesario por supuesto, no debería ser “Quiero un proyecto para implantar Bigdata/Blockchain/….” Sino “Este proceso/aplicación no es muy eficiente, convendría mejorarlo o implementarlo de nuevo” O “¿Qué sistemas podemos mejorar para que el proceso, coste o interacción con los usuarios/clientes mejore?”.

Si la respuesta a eso, tras un estudio, resulta ser que conviene implementar Blockchain/BigData/…., perfecto, bienvenido sea, pero el invertir tiempo y dinero en una tecnología por ser "moderna" nos lleva a un CPD tan “tuneado” e ineficiente como algunos de esos coches que podemos encontrar.


jueves, 7 de marzo de 2019

Los Framework de desarrollo, un "regalo envenenado"


Voy a expresar algo que, aunque a muchos desarrolladores “horrorizará”, estoy seguro de que muchos otros comparten: Los Framework  (marcos de desarrollo) son un “regalo envenenado”.

Aunque su uso está muy extendido y existen muchos Frameworks, generalmente suelo evitar su uso para los proyectos en que participo y creo que en muchos casos, a pesar de sus aparentes ventajas, son contraproducentes.

Por supuesto esto no es una norma absoluta, y hay casos en que sí me parece apropiado, ya sea por normalizar desarrollos o porque el proyecto lo requiera.
El problema es que muchos Arquitectos y Desarrolladores dan por supuesto que “deben utilizarse”, que "es la mejor opción" y “te miran como un marciano” si, por ejemplo, argumentas que prefieres no usar Hibernate.

Sin embargo, tal como predica el pensamiento crítico, no debemos asumir nada sin reflexionar. Argumento a continuación por qué no es tan evidente la ventaja.


Framework vs bibliotecas.

El primer punto a aclarar es la denominación de Framework de desarrollo y su diferencia con las bibliotecas de desarrollo, librerías o APIs de productos o servicios.

En cualquier lenguaje de programación, cuando hablamos de bibliotecas, nos referimos a un conjunto de funciones , métodos y clases que nos permiten realizar diversas operaciones (ordenar listas de valores, reproducir archivos de audio o video, generar gráficos, acceder a servicios o a bases de datos,  etc.). Por tanto cuando desarrollamos un programa y utilizamos bibliotecas, debemos construir y elaborar la lógica del programa, y cuando necesitamos utilizar unos servicios “especializados”, en lugar de programarlos desde cero, se acude a esas bibliotecas que alguien ha construido previamente (y que se habrán publicado como software libre o  como producto privativo, con sus correspondientes licencias). Es decir en este escenario, la lógica y el marco de trabajo lo impone el proyecto, que solo acude a las bibliotecas para algunas funciones.

En cambio, cuando desarrollamos utilizando algún framework (como AngularJS, Struts,  SpringBoot  o Ruby on Rails ) el marco o modelo de trabajo lo fija el Framework, que impone una estructura, una lógica y una forma de trabajo, dentro de la cual la tarea de desarrollo del proyecto es “rellenar los huecos” (lo que no implica que sea poco trabajo, pueden ser "huecos" enormes de miles de horas de desarrollo por supuesto).


Modelo MVC usado en Frameworks como Struts (by Wooptoo [Public domain])


Comparando con un modelo más cercano a todos, si estuviéramos construyendo una estantería para nuestra casa, el modelo de desarrollo basado en librerías equivaldría a cortar las maderas a medida y, para las piezas complicadas, como cajones o elementos abatibles, comprar esas piezas ya hechas.

En cambio el equivalente a utilizar un Framework sería comprar unas estanterías con unas dimensiones fijas, y rellenar los huecos con baldas para adaptarse a nuestras necesidades.

Por supuesto el modelo no es totalmente exacto y además en ocasiones la frontera es difusa, ya que los Framework tiene bibliotecas de funciones adicionales/complementarias y las bibliotecas en ocasiones imponen una forma de trabajo. Pero como aproximación creo que es válida.

Con una biblioteca, el desarrollador “manda”, dirige el flujo y lógica e invoca las funciones deseadas cuando se necesitan-

Con un Framework, el desarrollador se “adapta” al Framework, se ajusta a esa lógica y “contrato" y es “invocado” dentro de ese modelo.


Ventajas de los Framework.

Por supuesto, los Framework tienen muchas ventajas:
  • Conforman un esqueleto bien estructurado, con lo que no hay que pensar en muchos aspectos (gestión de errores, verificación datos, etc.), pues ya están previstos.
  • Cuando hay un equipo grande, o varios equipos en una empresa, asegura que todos los proyectos se desarrollen igual.
  • Las personas que se incorporen a la empresa, al ser un Framework estándar, es posible que conozcan ese Framework, y pueden ser productivos antes.

Telco [Public domain]
En muchas ocasiones, y como se da por supuesto que “los Framework son muy útiles y aumentan la productividad”, solo se recuerda las ventajas, o incluso no se analiza, simplemente se utilizan porque “ahora se programa así”.
Sin embargo, “no es oro todo lo que reluce”.


Inconvenientes de los Framework.

Entre los principales inconvenientes, puede citarse:
  • El “sobrepeso”: Muchos Framework son “monstruosos”, e introducen una sobrecarga muy importante, lo que implica mucho más hardware para poder prestar los mismos servicios. El ahorro en tiempo de desarrollo puede no compensar el coste en infraestructura adicional.
  • La compatibilidad: En ocasiones, los Framework cambian la forma de trabajo y te obligan a cambiar gran parte del código y/o de la lógica de un proyecto. Quizá un ejemplo “sangrante” es el cambio en alguna versión de AngularJS, que lo convertía en totalmente incompatible con la versión anterior. En cambio, si una biblioteca cambia ciertos métodos o clases, es posible realizar cambios en la llamada a esos métodos, o incluso crear un recubrimiento con el “contrato” anterior, que convierta internamente las llamadas al nuevo estilo, sin afectar demasiado al grueso del programa.
  • El exceso de dependencias: Es habitual que muchos Framework arrastren muchas herramientas y bibliotecas. ¿Qué ocurre si además del Framework queremos usar otras bibliotecas, como es habitual? Esas bibliotecas, que en ocasiones requieren bibliotecas adicionales complicando aún más el escenario, pueden colisionar con las del propio Framework. El resultado es que no puedes utilizar la biblioteca que deseas y hay que buscar otras. Hay otro efecto peor, que es que la incompatibilidad surja a posteriori, es decir cuando se actualiza la versión del Framework y descubres que colisiona con alguno de los elementos que ya utilizas, lo que obliga a hacer (bastantes) cambios. Por supuesto, pueden surgir colisiones entre bibliotecas aunque no se utilice Framework, pero las probabilidades son menores y, además, siempre pueden cambiarse por otras con menos impacto que el rehacer toda la lógica.
  • La continuidad en el tiempo: Si una biblioteca desaparece, se cambia por otra con relativo esfuerzo. Si un Framework desaparece, hay que “rehacer” el proyecto.
  • El aprendizaje: Los Framework suelen ser grandes y complejos, lleva tiempo aprenderlos y entender la lógica y empezar a desarrollar bajo ellos.
  • La evolución: Al ser muy grandes, la evolución puede ser lenta y no estar disponibles para, por ejemplo, la última versión de Java, base de datos, navegador o sistema operativo.


¿Hay alternativas?

Si se desea acelerar el desarrollo, aumentar la calidad (evitando errores) y seguir una estructura común (para facilitar la movilidad entre equipos). ¿No hay más remedio que utilizar Framework?

No necesariamente, hay diversos recursos:
  • Crear un mini-Framework propio, creando una estructura de clases que gestionen el esqueleto, incluyendo todos los controles de errores y escenarios necesarios, y dejando que los proyectos creen subclases y sobrecarguen los elementos necesarios. No serán tan sofisticados como un framework, pero a cambio:
    • Estarán más adaptados a nuestros desarrollos y negocio
    • Serán mucho más ligeros
    • No se depende de terceros y por tanto pueden evolucionarse como nuestros desarrollos requieran.
  • Crear patrones internos, de forma que los desarrollos tengan un modelo o proyecto tipo, que se copie y cambie.
  • Definir normativas y recomendaciones internas.
  •  . . . .


Conclusiones

Creo que si se desea un nuevo proyecto (o reorganizar un equipo de desarrollo), antes de asumir que se utilizará el Framework XYZ (o al contrario, asumir que NO se utilizará NINGÚN Framework) es imprescindible plantearse preguntas como:

¿Cuánto ahorro en tiempo de desarrollo frente a cuánto tardo en aprenderlo?
¿Aprovecho el 100% del Framework o solo un pequeño porcentaje?
¿Es más eficaz utilizar uno o construir uno mismo un pequeño framework o librerías?
¿Es estable o puede cambiar?
¿Qué sobrecarga introduce en términos de recursos de máquina requeridos?
¿Es válido para muchos proyecto o solo este?
¿Arrastrar muchas librerías? ¿Cuales?
¿Qué limitaciones de ejecución y plataforma me impone?
. . .

Una vez sopesadas todas las opciones, con una visión crítica podremos elegir la más adecuada que en ocasiones podrá ser la que inicialmente esperábamos como “normal” y en otros casos no, pero en cualquier caso habrá sido una decisión sopesada y SIN ASUMIR nada.


domingo, 21 de octubre de 2018

Productividad=Organización+Documentación


Básicamente se define productividad como la relación entre la producción obtenida (servicios, productos, ..) y los recursos empleados en la producción (materiales, personal, tiempo, etc.).

Lamentablemente, en muchas ocasiones se asocia mentalmente “productividad”,  a “lo que produce cada empleado”, es decir, “lo que se obtiene de cada sueldo” por lo que la forma de aumentar la productividad es que los empleados “trabajen mucho y cobren poco”. Aunque eso desde luego reduzca los costes, es tan erróneo como plantear que “se aumentará la productividad si no se compran ordenadores”, ya que “reducimos los costes” o que “el reparto se haga andando, para evitar la compra y mantenimiento de vehículos”.

Creo que en ámbito de las TI (como casi en cualquier otro sector por otra parte) los elementos más importantes para mejorar la productividad son la organización y la documentación. Desde luego también es importante el contar con buenos profesionales y con buenos instrumentos (tal como he argumentado anteriormente [La "barrera del sonido"]y[El altísimo coste del “ahorro” en ordenadores y equipamiento], aunque no dentro del enfoque de la productividad).

Sin embargo el mejor técnico y el mejor ordenador son casi inútiles en una entorno de trabajo desorganizado e ”indocumentado”, y lamentablemente eso es algo demasiado habitual.


Algunos ejemplos


Quizá el ejemplo más claro que conozco de cómo mejorar la productividad es este:


Un banco de alimentos creado tras unas inundaciones en Nueva York, organizado por una persona de buena voluntad y con mano de obra voluntaria mejoró espectacularmente su productividad  (cantidad de lotes de comida repartida) simplemente organizando mejor su trabajo y con unos mínimos costes.

Por otra parte, en el aspecto negativo, hay muchos ejemplos de tiempo perdido por falta de organización o documentación.
Por ejemplo:

  • ¿Quién no ha tenido que rehacer un proyecto porque, tras estar parcial o incluso totalmente desarrollado, un área con la que no se ha contado introduce nuevo requisitos o vetos debido a que no se cumple ciertas características? Si el proceso de definición de un nuevo proyecto (con todos sus intervinientes y momentos de intervención) estuviera definido, no se produciría esta pérdida. Todo esto es un coste evidente que  afecta negativamente a la productividad Ya que el resultado obtenido puede haber costado en ocasiones el doble de lo que costaría con un circuito bien definido.

  • ¿Quién no ha sufrido retrasos debido a que no está especificado quien debe aprobar/revisar/arreglar/instalar algún elemento? En ocasiones todo un equipo implicado en un proyecto tiene que esperar a que se confirme (o improvise) un circuito. De nuevo, son muchas horas perdidas debido a esta carencia. Incluso aunque el equipo implicado pueda ocuparse en otras tareas, siempre hay un tiempo empleado en la búsqueda, hay una pérdida de tiempo hasta que se decide que ”no se sabe” y sobre todo, de oportunidad al no cumplirse plazos.

  • Otro ejemplo habitual es la no disponibilidad de un ordenador cuando se incorpora un empleado. Estos retrasos pueden llegar a ser de 1 mes, y es evidente que, dado que es necesario un preaviso en su empresa por parte del futuro empleado, preparar el nuevo contrato en la empresa contratante, etc. se dispone de al menos 15 días desde que se sabe que se va a contratar a una persona concreta para un puesto concreto. Un circuito bien organizado puede asegurar que todo el equipo y elementos necesarios estén disponibles. De nuevo es un problema organizativo que, de no estar bien estructurado, es muy costoso.


Realmente no es tan difícil y merece la pena 


Todos estos escenarios representan costes que hacen que la productividad (recordemos, producto obtenido frente a costes/recursos aportados) se reduzca y que con un mínimo de organización pueden minimizarse. Puede argumentarse que es difícil calcular los costes, pero no lo es tanto.

Por ejemplo que un nuevo empleado esté 2 semanas sin ordenador (es decir unas 80h improductivas), asumiendo un salario de solo 24.000€, lo que implica unos costes de unos 20€/h, equivale a 1600€. En el caso de un proyecto que hay que modificar o retrasar, desde luego es más difícil, pero puede hacerse una estimación de riesgos (al igual que las compañías de seguros con los accidentes) teniendo en cuenta el coste total del proyecto y la probabilidad de cambio (que puede afirmarse que es casi “inversamente proporcional a la calidad de la organización”).

En cuanto a la documentación, suele estar igualmente “olvidada”. La documentación, en el mejor de los casos está en una herramienta de colaboración, y en la mayoría, en una carpeta de red o incluso en los equipos personales. No es demasiado habitual que esté en un gestor documental, que como su nombre indica, es la herramienta adecuada para gestionar documentos. Parece ridículo tener que recordarlo, pero lamentablemente pocas empresas tiene su documentación en un gestor documental. 

El resultado es que se emplea mucho tiempo buscando documentación (o bien porque puede estar en múltiples localizaciones, o bien porque no puede localizarse al estar incorrectamente catalogada y clasificada, con los metadatos adecuados o no está clara la última versión.

Todo ello conlleva pérdidas de tiempo, y en el peor de los casos, toma de decisiones incorrectas al basarse en documentación obsoleta, por ejemplo asumir comportamientos de versiones anteriores, o funcionamiento bajo versiones de infraestructura (Sistema Operativo, base de datos, versiones de java, servidores Web o J2EE,..) obsoletas o fuera de soporte.

Mención aparte merece la “calidad” de la documentación, independientemente del lugar en que se almacene o la corrección de su catalogación. Aunque cada vez es menos frecuente, sigue siendo bastante habitual que el “becario” o alguien “que pasa por allí”, se encargue de la documentación de muchos proyectos tecnológicos. Como consecuencia, esa documentación en muchas ocasiones simplemente detalla lo que hace la aplicación (cosa que por otra parte puede verse viéndola trabajar) y los componentes que tiene (lo que puede verse revisando el código fuente y el paquete de instalación) pero no explica realmente el funcionamiento interno, o porqué se han tomado ciertas decisiones. Es decir la información realmente importante y que conocen los perfiles más implicados en el desarrollo y con más experiencia.

Al final la productividad en muchos casos se reduce a la mitad (y no es exageración, he visto proyectos que han duplicado la carga de trabajo prevista, debido a problemas como los anteriores), algo que podría evitarse simplemente con mejor organización y documentación.


viernes, 18 de mayo de 2018

La "barrera del sonido"


Recuerdo haber oído esta expresión a dos empleados de recursos humanos tomando un café, hace muchos años en una consultora en que trabajaba. Se referían a un candidato que había “traspasado la barrera del sonido”, es decir, había superado cierta edad (desconozco si podían ser 40 o 50 años), lo que prácticamente lo descalificaba para el puesto.

Aunque el tema de la edad laboral se ha tratado en numerosas ocasiones por especialistas, y aunque parece ridículo tener que argumentar sobre algo tan evidente, especialmente en el ámbito de las Tecnologías de la Información que es el que mejor conozco, creo que no está de más volver a reflexionar sobre el alto coste económico que tiene para una empresa de Tecnologías de  la INFORMACIÓN el “tirar a la basura” toda esa INFORMACIÓN y experiencia que albergan empleados a los que se prejubila o que tienen esos candidatos a los que no se contrata.
Quizá lo primero a destacar que es creo que este modelo es principalmente aplicable a España. Los datos de que dispongo, tanto obtenidos desde Internet como directamente de otros profesionales (compañeros o proveedores) que trabajan en otros países, muestran que no ocurre, o no con tanta frecuencia, en otros países.

By Internet Archive Book Images, via Wikimedia Commons

Escenarios de “derroche”


Creo que en las empresas de TI hay tres formas en que se desperdicia el capital humano por la edad:
  • Estructura de la carrera profesional
  • Prejubilaciones y despidos
  • No contratación por edad


Estructura de la carrera profesional


En la mayoría de las empresas de TI no existe REALMENTE una carrera profesional PROLONGADA que permita a un buen técnico seguir evolucionando en su carrera aumentando el RECONOCIMIENTO profesional y el SUELDO.
En gran parte de las empresas de tecnología la evolución implicar dejar de ser técnico y convertirse en gestor (si se desea que el sueldo y el reconocimiento aumenten). Esto provoca que, en ocasiones, la empresa pierda un buen técnico y adquiera un mal gestor (según el clásico Principio de Incompetencia de Peter ).
Por supuesto no quiere decir que todos los jefes de proyecto deban proceder carreras de gestión (es habitual ver resultados desastrosos cuando alguien que no conoce las singularidades y características del desarrollo de software intenta gestionar o dirigir el trabajo, por lo que es recomendable que la gestión la realicen personas con experiencia en tecnología), sino que la evolución debe ser por convencimiento e interés y no de forma “forzada” para no quedarse estancado.
El resultado es que esa experiencia y conocimientos se pierden y la empresa, que posiblemente ha sustituido en  su “pool” de técnicos un perfil “caro” por uno “barato”, en lugar de aumentar su beneficio, pierde en eficiencia (produce más barato pero probablemente  más lento y con peor calidad) y posiblemente pueda tener más errores o retrasos, con los costes asociados.
Esto desde luego no ocurre, o no de forma tan acusada, en otros países (basta comparar las bandas salariales o las ofertas de empleo habituales en España y otros países). Esto se evitaría si, como ocurre en otros países, puedes encontrar un programador con 60 años al que todo el mundo consulta y respeta  al que se encarga los proyectos difíciles y pide asesoramiento.

Prejubilaciones y despidos


A lo anterior hay que sumar los despidos o prejubilaciones a partir de una edad. El argumento, que en algunos casos puntuales es cierto, de dificultad o incapacidad para reciclarse, en la mayoría de los casos no tiene ningún soporte objetivo.
El mundo de las TI ha cambiado radicalmente cada pocos años y la mayoría de los profesionales han tenido que aprender nuevas herramientas y sobre todo nuevos paradigmas y tecnologías.
El despido de esos profesionales que conocen los proyectos y herramientas de la empresa, dado que muchas veces la documentación es incompleta, o incluso no existe, hace que se pierda mucho valor y mucha productividad.
En el mejor de los casos, se perderán varios meses hasta que una nueva persona, sin experiencia, aprenda todos los detalles, por lo que el ahorro en salarios debe minorarse restando todos esos meses improductivos.
En el peor, no habrá nadie capaz de asumir la tarea, o quien la asuma lo hará con errores que tiene un coste.
Y ese coste puede ser muy grande (indemnizaciones a clientes, perdida de muchas horas de trabajo de empleados,..).
Lamentablemente no se suele imputar esos errores o pérdidas al departamento que “ha ahorrado” sino que en ocasiones parece atribuirse a “una conjunción de astros” o a “lo complicada que es la informática” por lo que no hay forma de comparar el impacto real de esos “ahorros”.
Una imputación real de lo que cuesta esos “ahorros” sustituyendo a profesionales avezados por becarios posiblemente mostrara cifras mucho peores y probablemente costes mayores.
Nadie responsable plantea usar tornillos de mala calidad para utilizarlos en piezas estructurales y sin embargo sí se considera “normal” prejubilar a profesionales “de calidad” y sustituirlos por profesionales sin experiencia. La diferencia es que cuando un tornillo se rompe y la empresa tiene que pagar indemnizaciones, las responsabilidades y la causa suele ser más clara, mientras que si un desarrollo falla y la empresa tiene que asumir indemnizaciones, la causa no siempre se plantea de forma tan clara.
Por último, como ejemplo claro del absurdo a que se llega, conozco al menos dos casos de empresas que prejubilaron a técnicos (con su indemnización correspondiente) y tras descubrir que nadie conocía cómo hacer su trabajo, tuvieron que contratarles de nuevo como consultores externos (con sus costes extras).

No contratación por edad


Los casos anteriores se producen con empleados dentro de la empresa, pero un porcentaje importante de los casos se produce por la no contratación de profesionales que han superado cierta edad.
Desde luego en este caso no aplica la obsolescencia de conocimientos o imposibilidad de reciclar, ya que si no conocen la tecnología o disciplina para la que se les requiere, no hay por qué contratarles, independientemente de su edad.
Por tanto el único motivo puede ser la edad, y en ocasiones, su banda salarial, que puede ser más alta que la de un recién licenciado. Como en el caso anterior, parece claro que la productividad y calidad compensan (en gran parte de los casos) el coste sobre un recién licenciado.


Lamentablemente, parece que estas “manías” (no he encontrado en mi vida nadie que sea capaz de dar una argumentación coherente a este tema, por lo que solo puede tacharse de “moda” o “manía”)  se extienden a algunas empresas que mantenían un criterio coherente: https://www.elconfidencial.com/alma-corazon-vida/2018-05-04/empresas-trabajar-discriminacion-edad_1558692/

0 A.D. game Wildfire games (CC)
Es curioso, que ahora que está tan de moda la gamificación, y que además hace tiempo que se considera que los juegos permiten aprender técnicas y estrategias luego aplicables a la vida empresarial, no se recuerda algo que cualquier jugador de juegos de estrategia conoce:

En la mayoría de juegos de estrategia, la táctica ganadora pasa siempre por tener pocos soldados muy bien equipados y con mucha experiencia  (“caros”) y no en tener muchos  “baratos”. 

Y eso se lleva aplicando desde hace siglos al juego de estrategia por antonomasia, el ajedrez. Ningún jugador cambiaría una reina por dos o tres peones.

By User:Mutante [CC], from Wikimedia Commons


Como en otros casos, esperemos que una revisión crítica de los costes e impacto real de los “ahorros” en personal, al igual que he comentado respecto al material de trabajo  reconduzca la situación.


viernes, 16 de marzo de 2018

Por qué Bigdata no es para todo el mundo.

En estos últimos años ha “subido como la espuma” el interés por Bigdata. Parece que no hay empresa que no considere que debe invertir en Bigdata ni profesional que no considere que es un sector de futuro. Sin embargo, como indica el título de esta entrada, creo que Bigdata “no es para todos”, por su propia esencia.

By Magnai17 (Own work) [CC], via Wikimedia Commons


Repasando Bigdata.

Como es sabido, Bigdata (llamado en ocasiones Macrodatos en castellano) es un concepto que hace referencia a enormes volúmenes de datos, que no pueden ser tratados con las bases de datos tradicionales.
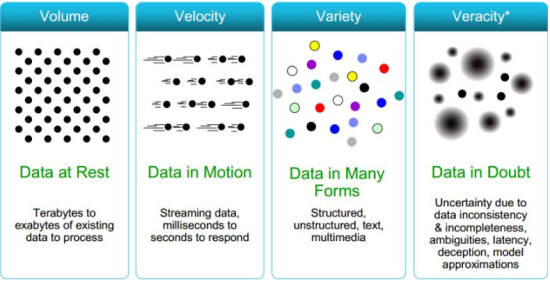
Los proyectos de Bigdata no solo se caracterizan por la cantidad de datos; tradicionalmente se ha definido que tienen tres características, las 3 V: Volumen, Velocidad, y Variedad.

  • Volumen hace referencia a la cantidad de los datos. Cuando se habla de Bigdata, estamos hablando de volúmenes MUY  grandes, de las decenas de TERAS en adelante, es decir hablamos de almacenar un mínimo de 10.000.000.000.000 caracteres. Los expertos en Bigdata suelen recomendar otras tecnologías para volúmenes inferiores, aunque sean “muy grandes”.  Para hacerse una idea de lo que implica, si pensamos que una llamada de teléfono se puede almacenar usando 11 dígitos del “llamante”+11 dígitos del llamado+5 de la duración+12 de la fecha hora, es decir 40 dígitos (realmente sería la mitad en base de datos, pero obviamos eso de momento) y dividimos 10Teras/40/50 Millones de habitantes, eso nos da que estaríamos hablando de 5.000 llamadas de cada habitante de España. Otra comparación podría ser el pensar en movimientos bancarios. Si contamos 50 caracteres por movimiento y pensando en un banco que tenga 10M de cuentas, nos da 20.000 movimientos (transferencias, entradas, etc.) de cada cuenta/cliente.
  • Velocidad hace referencia a la cantidad de datos que deben incorporarse por unidad de tiempo. Se trata de sistemas donde se puede generar cientos de miles de entrada por hora. Lógicamente, para alcanzar esos volúmenes no puede alimentarse con unos pocos registros cada hora, ya que se tardaría años en rellenarla la información.
  • Variedad hace referencia a la variedad de datos a manejar INCLUSO para la misma tabla/entidad. Es decir, no se trata de manejar 10 millones de asientos contables todos iguales sino de intentar manejar “juntos” elementos caracterizados por distintos metadatos.

Estos requerimientos han provocado que se utilicen tipos de herramientas distintas a los gestores de bases de datos tradicionales. Generalmente se utilizan Bases de Datos NoSQL como MongoDB , Cassandra o HBase  que utilizan un modelo no relacional .

El hecho de prescindir de la normalización de la base de datos  y de recursos habituales en las bases de datos “tradicionales” como transacciones (es decir poder agrupar las operaciones en paquetes de operaciones coherentes, de forma que se haga todo o nada), claves únicas (es decir asegurar que no se introduzca dos veces el mismo valor) o claves ajenas (que asegura que no se referencia una entrada que se borra por otra operación) elimina muchas de las sobrecargas sobre los sistemas  tradicionales, permitiendo velocidades de ingestión de los datos mucho mayores (al no tener que realizar comprobaciones de los valores), y una escalabilidad muy grande (al poder distribuirse la carga entre muchos nodos que no deben mantener la coherencia).

En cualquier caso, aunque no sean bases de datos “tradicionales” que tengan un modelo totalmente normalizado hasta la 3ª o 5º forma normal, siguen siendo bases de datos, es decir tiene una estructura de información, la diferencia es que podemos tener, por ejemplo, una factura con todos sus ítem en una “tabla”, algo que en un modelo normalizado requeriría dos o tres tablas.

En ocasiones surge cierta confusión en cuanto al uso, asumiendo que, por ejemplo, pueden utilizarse para clasificar textos, área para la que están mucho más preparadas herramientas como las herramientas de NLP (Natural Language Processing: Procesamiento del lenguaje natural), Machine Learning,  o Content Analytics. Ese sería otro ámbito de trabajo con otras características.


Courtesy NASA/JPL-Caltech [Attribution or Public domain], via Wikimedia Commons

Por qué no es para todas las empresas o instituciones.


La variedad de datos se da en muchos ámbitos y modelos que puedan realizarse de actividades humanas, sin embargo,

 ¿Cuántas actividades humanas generan esa cantidad de datos?

Y lo más importante

¿Cuántas empresas e instituciones tienen acceso, generan o reciben esa cantidad de información?

Como puede verse por las cifras, no es muy habitual manejar esa cantidad de información.
Y si se trata de cifras inferiores, NO es Bigdata, o NO es adecuado tratarlo con herramientas de Bigdata.
Debe además descontarse los escenarios donde se manejan millones de datos pero son texto (por lo que aplicarían las herramientas de manejo de textos antes citadas).

Por último un detalle menor.
Aunque después de frases famosas como la atribuida (incorrectamente ) a Bill Gates acerca de que “640K deben ser suficientes”  o la del presidente de IBM  Thomas J. Watson en 1948 de “Creo que habrá mercado mundial para cinco computadores” es muy “arriesgado” hacer previsiones, y aunque los costes de almacenamiento e infraestructura de ordenadores han bajado mucho y siguen bajando, a día de hoy manejar toda esa información de forma rápida y eficiente sigue siendo caro y complejo.

En cualquier caso es un obstáculo menor, que perderá cada vez más peso frente al problema principal de cualquier empresa o institución: ¿De dónde obtengo información que justifique el uso de Bigdata?


By Magnai17 (Own work) [CC], via Wikimedia Commons

Por qué no es para todos los profesionales.


En ocasiones se leen opiniones de profesionales que manejan otros tipo de información (contenidos, documentación, etc.) acerca de lo cercano o adecuado que es su perfil para volcarse en el mundo de Bigdata. Sin embargo, aunque sea un nuevo sector, no hay que olvidar que se trata de manejar bases/volúmenes de datos. No seguirán un modelo relacional, pero siguen un modelo, con sus columnas, conjuntos de metadatos, sus relaciones, su integridad mayor o menor, incluso sus transacciones (recientemente MongoDB ha cubierto esa carencia  ).
Quien no haya manejado esos conceptos, reflexionado sobre como optimizar un modelo de datos, crear índices o resolver problemas de rendimiento en una base de datos con 20 millones de registros, posiblemente no pueda sacar rendimiento de un proyecto de Bigdata.
Al igual que no es lo mismo un pintor que tras dominar el arte figurativo evoluciona hacia el abstracto que alguien que no sabe pintar y hace cuadros “abstractos”, no es lo mismo alguien que domina las bases de datos y evoluciona a Bigdata que  alguien que nunca ha trabajado con bases de datos.
Por supuesto todos podemos reciclarnos, formarnos y aprender nuevas disciplinas, al igual que puede haber expertos en bases de datos que se queden anclados y no sepan dar el paso a Bigdata (como puede ocurrir a un pintor que no sepa dar el paso a arte abstracto), solo quiero resaltar que, en principio, por su  experiencia y bagaje técnico, los profesionales especializados actualmente en bases de datos (administradores de bases de datos, diseñadores de bases de datos, expertos en data DataWarehouse, etc.), así como los expertos en análisis de datos y estadística son los que tendrán más facilidad para poder enfrentarse con proyectos de Bigdata.

Conclusión


Para no dejarse arrastrar por la ola de entusiasmo, creo que lo más recomendable para las empresas e instituciones, antes de plantearse iniciar un proyecto de Bigdata, sería reflexionar sobre:
  1. ¿Tengo en mis procesos y sistemas de información esos volúmenes de datos?
  2. Si se trata de información que no puede/debe tratarse con un modelo relacional ¿no bastaría plantearse el uso de una base de datos NoSQL con un modelo no normalizado?
Y para los profesionales que se plantean acercarse a ese mundo:
  1. ¿Pretendo CONOCER Bigdata (una disciplina nueva e interesante) o TRABAJAR en Bigdata?
  2. Si pretendo trabajar, ¿Mis conocimientos y los cursos que estoy evaluando son suficientemente profundos y adecuados?