domingo, 21 de octubre de 2018

Productividad=Organización+Documentación


Básicamente se define productividad como la relación entre la producción obtenida (servicios, productos, ..) y los recursos empleados en la producción (materiales, personal, tiempo, etc.).

Lamentablemente, en muchas ocasiones se asocia mentalmente “productividad”,  a “lo que produce cada empleado”, es decir, “lo que se obtiene de cada sueldo” por lo que la forma de aumentar la productividad es que los empleados “trabajen mucho y cobren poco”. Aunque eso desde luego reduzca los costes, es tan erróneo como plantear que “se aumentará la productividad si no se compran ordenadores”, ya que “reducimos los costes” o que “el reparto se haga andando, para evitar la compra y mantenimiento de vehículos”.

Creo que en ámbito de las TI (como casi en cualquier otro sector por otra parte) los elementos más importantes para mejorar la productividad son la organización y la documentación. Desde luego también es importante el contar con buenos profesionales y con buenos instrumentos (tal como he argumentado anteriormente [La "barrera del sonido"]y[El altísimo coste del “ahorro” en ordenadores y equipamiento], aunque no dentro del enfoque de la productividad).

Sin embargo el mejor técnico y el mejor ordenador son casi inútiles en una entorno de trabajo desorganizado e ”indocumentado”, y lamentablemente eso es algo demasiado habitual.


Algunos ejemplos


Quizá el ejemplo más claro que conozco de cómo mejorar la productividad es este:


Un banco de alimentos creado tras unas inundaciones en Nueva York, organizado por una persona de buena voluntad y con mano de obra voluntaria mejoró espectacularmente su productividad  (cantidad de lotes de comida repartida) simplemente organizando mejor su trabajo y con unos mínimos costes.

Por otra parte, en el aspecto negativo, hay muchos ejemplos de tiempo perdido por falta de organización o documentación.
Por ejemplo:

  • ¿Quién no ha tenido que rehacer un proyecto porque, tras estar parcial o incluso totalmente desarrollado, un área con la que no se ha contado introduce nuevo requisitos o vetos debido a que no se cumple ciertas características? Si el proceso de definición de un nuevo proyecto (con todos sus intervinientes y momentos de intervención) estuviera definido, no se produciría esta pérdida. Todo esto es un coste evidente que  afecta negativamente a la productividad Ya que el resultado obtenido puede haber costado en ocasiones el doble de lo que costaría con un circuito bien definido.

  • ¿Quién no ha sufrido retrasos debido a que no está especificado quien debe aprobar/revisar/arreglar/instalar algún elemento? En ocasiones todo un equipo implicado en un proyecto tiene que esperar a que se confirme (o improvise) un circuito. De nuevo, son muchas horas perdidas debido a esta carencia. Incluso aunque el equipo implicado pueda ocuparse en otras tareas, siempre hay un tiempo empleado en la búsqueda, hay una pérdida de tiempo hasta que se decide que ”no se sabe” y sobre todo, de oportunidad al no cumplirse plazos.

  • Otro ejemplo habitual es la no disponibilidad de un ordenador cuando se incorpora un empleado. Estos retrasos pueden llegar a ser de 1 mes, y es evidente que, dado que es necesario un preaviso en su empresa por parte del futuro empleado, preparar el nuevo contrato en la empresa contratante, etc. se dispone de al menos 15 días desde que se sabe que se va a contratar a una persona concreta para un puesto concreto. Un circuito bien organizado puede asegurar que todo el equipo y elementos necesarios estén disponibles. De nuevo es un problema organizativo que, de no estar bien estructurado, es muy costoso.


Realmente no es tan difícil y merece la pena 


Todos estos escenarios representan costes que hacen que la productividad (recordemos, producto obtenido frente a costes/recursos aportados) se reduzca y que con un mínimo de organización pueden minimizarse. Puede argumentarse que es difícil calcular los costes, pero no lo es tanto.

Por ejemplo que un nuevo empleado esté 2 semanas sin ordenador (es decir unas 80h improductivas), asumiendo un salario de solo 24.000€, lo que implica unos costes de unos 20€/h, equivale a 1600€. En el caso de un proyecto que hay que modificar o retrasar, desde luego es más difícil, pero puede hacerse una estimación de riesgos (al igual que las compañías de seguros con los accidentes) teniendo en cuenta el coste total del proyecto y la probabilidad de cambio (que puede afirmarse que es casi “inversamente proporcional a la calidad de la organización”).

En cuanto a la documentación, suele estar igualmente “olvidada”. La documentación, en el mejor de los casos está en una herramienta de colaboración, y en la mayoría, en una carpeta de red o incluso en los equipos personales. No es demasiado habitual que esté en un gestor documental, que como su nombre indica, es la herramienta adecuada para gestionar documentos. Parece ridículo tener que recordarlo, pero lamentablemente pocas empresas tiene su documentación en un gestor documental. 

El resultado es que se emplea mucho tiempo buscando documentación (o bien porque puede estar en múltiples localizaciones, o bien porque no puede localizarse al estar incorrectamente catalogada y clasificada, con los metadatos adecuados o no está clara la última versión.

Todo ello conlleva pérdidas de tiempo, y en el peor de los casos, toma de decisiones incorrectas al basarse en documentación obsoleta, por ejemplo asumir comportamientos de versiones anteriores, o funcionamiento bajo versiones de infraestructura (Sistema Operativo, base de datos, versiones de java, servidores Web o J2EE,..) obsoletas o fuera de soporte.

Mención aparte merece la “calidad” de la documentación, independientemente del lugar en que se almacene o la corrección de su catalogación. Aunque cada vez es menos frecuente, sigue siendo bastante habitual que el “becario” o alguien “que pasa por allí”, se encargue de la documentación de muchos proyectos tecnológicos. Como consecuencia, esa documentación en muchas ocasiones simplemente detalla lo que hace la aplicación (cosa que por otra parte puede verse viéndola trabajar) y los componentes que tiene (lo que puede verse revisando el código fuente y el paquete de instalación) pero no explica realmente el funcionamiento interno, o porqué se han tomado ciertas decisiones. Es decir la información realmente importante y que conocen los perfiles más implicados en el desarrollo y con más experiencia.

Al final la productividad en muchos casos se reduce a la mitad (y no es exageración, he visto proyectos que han duplicado la carga de trabajo prevista, debido a problemas como los anteriores), algo que podría evitarse simplemente con mejor organización y documentación.


viernes, 18 de mayo de 2018

La "barrera del sonido"


Recuerdo haber oído esta expresión a dos empleados de recursos humanos tomando un café, hace muchos años en una consultora en que trabajaba. Se referían a un candidato que había “traspasado la barrera del sonido”, es decir, había superado cierta edad (desconozco si podían ser 40 o 50 años), lo que prácticamente lo descalificaba para el puesto.

Aunque el tema de la edad laboral se ha tratado en numerosas ocasiones por especialistas, y aunque parece ridículo tener que argumentar sobre algo tan evidente, especialmente en el ámbito de las Tecnologías de la Información que es el que mejor conozco, creo que no está de más volver a reflexionar sobre el alto coste económico que tiene para una empresa de Tecnologías de  la INFORMACIÓN el “tirar a la basura” toda esa INFORMACIÓN y experiencia que albergan empleados a los que se prejubila o que tienen esos candidatos a los que no se contrata.
Quizá lo primero a destacar que es creo que este modelo es principalmente aplicable a España. Los datos de que dispongo, tanto obtenidos desde Internet como directamente de otros profesionales (compañeros o proveedores) que trabajan en otros países, muestran que no ocurre, o no con tanta frecuencia, en otros países.

By Internet Archive Book Images, via Wikimedia Commons

Escenarios de “derroche”


Creo que en las empresas de TI hay tres formas en que se desperdicia el capital humano por la edad:
  • Estructura de la carrera profesional
  • Prejubilaciones y despidos
  • No contratación por edad


Estructura de la carrera profesional


En la mayoría de las empresas de TI no existe REALMENTE una carrera profesional PROLONGADA que permita a un buen técnico seguir evolucionando en su carrera aumentando el RECONOCIMIENTO profesional y el SUELDO.
En gran parte de las empresas de tecnología la evolución implicar dejar de ser técnico y convertirse en gestor (si se desea que el sueldo y el reconocimiento aumenten). Esto provoca que, en ocasiones, la empresa pierda un buen técnico y adquiera un mal gestor (según el clásico Principio de Incompetencia de Peter ).
Por supuesto no quiere decir que todos los jefes de proyecto deban proceder carreras de gestión (es habitual ver resultados desastrosos cuando alguien que no conoce las singularidades y características del desarrollo de software intenta gestionar o dirigir el trabajo, por lo que es recomendable que la gestión la realicen personas con experiencia en tecnología), sino que la evolución debe ser por convencimiento e interés y no de forma “forzada” para no quedarse estancado.
El resultado es que esa experiencia y conocimientos se pierden y la empresa, que posiblemente ha sustituido en  su “pool” de técnicos un perfil “caro” por uno “barato”, en lugar de aumentar su beneficio, pierde en eficiencia (produce más barato pero probablemente  más lento y con peor calidad) y posiblemente pueda tener más errores o retrasos, con los costes asociados.
Esto desde luego no ocurre, o no de forma tan acusada, en otros países (basta comparar las bandas salariales o las ofertas de empleo habituales en España y otros países). Esto se evitaría si, como ocurre en otros países, puedes encontrar un programador con 60 años al que todo el mundo consulta y respeta  al que se encarga los proyectos difíciles y pide asesoramiento.

Prejubilaciones y despidos


A lo anterior hay que sumar los despidos o prejubilaciones a partir de una edad. El argumento, que en algunos casos puntuales es cierto, de dificultad o incapacidad para reciclarse, en la mayoría de los casos no tiene ningún soporte objetivo.
El mundo de las TI ha cambiado radicalmente cada pocos años y la mayoría de los profesionales han tenido que aprender nuevas herramientas y sobre todo nuevos paradigmas y tecnologías.
El despido de esos profesionales que conocen los proyectos y herramientas de la empresa, dado que muchas veces la documentación es incompleta, o incluso no existe, hace que se pierda mucho valor y mucha productividad.
En el mejor de los casos, se perderán varios meses hasta que una nueva persona, sin experiencia, aprenda todos los detalles, por lo que el ahorro en salarios debe minorarse restando todos esos meses improductivos.
En el peor, no habrá nadie capaz de asumir la tarea, o quien la asuma lo hará con errores que tiene un coste.
Y ese coste puede ser muy grande (indemnizaciones a clientes, perdida de muchas horas de trabajo de empleados,..).
Lamentablemente no se suele imputar esos errores o pérdidas al departamento que “ha ahorrado” sino que en ocasiones parece atribuirse a “una conjunción de astros” o a “lo complicada que es la informática” por lo que no hay forma de comparar el impacto real de esos “ahorros”.
Una imputación real de lo que cuesta esos “ahorros” sustituyendo a profesionales avezados por becarios posiblemente mostrara cifras mucho peores y probablemente costes mayores.
Nadie responsable plantea usar tornillos de mala calidad para utilizarlos en piezas estructurales y sin embargo sí se considera “normal” prejubilar a profesionales “de calidad” y sustituirlos por profesionales sin experiencia. La diferencia es que cuando un tornillo se rompe y la empresa tiene que pagar indemnizaciones, las responsabilidades y la causa suele ser más clara, mientras que si un desarrollo falla y la empresa tiene que asumir indemnizaciones, la causa no siempre se plantea de forma tan clara.
Por último, como ejemplo claro del absurdo a que se llega, conozco al menos dos casos de empresas que prejubilaron a técnicos (con su indemnización correspondiente) y tras descubrir que nadie conocía cómo hacer su trabajo, tuvieron que contratarles de nuevo como consultores externos (con sus costes extras).

No contratación por edad


Los casos anteriores se producen con empleados dentro de la empresa, pero un porcentaje importante de los casos se produce por la no contratación de profesionales que han superado cierta edad.
Desde luego en este caso no aplica la obsolescencia de conocimientos o imposibilidad de reciclar, ya que si no conocen la tecnología o disciplina para la que se les requiere, no hay por qué contratarles, independientemente de su edad.
Por tanto el único motivo puede ser la edad, y en ocasiones, su banda salarial, que puede ser más alta que la de un recién licenciado. Como en el caso anterior, parece claro que la productividad y calidad compensan (en gran parte de los casos) el coste sobre un recién licenciado.


Lamentablemente, parece que estas “manías” (no he encontrado en mi vida nadie que sea capaz de dar una argumentación coherente a este tema, por lo que solo puede tacharse de “moda” o “manía”)  se extienden a algunas empresas que mantenían un criterio coherente: https://www.elconfidencial.com/alma-corazon-vida/2018-05-04/empresas-trabajar-discriminacion-edad_1558692/

0 A.D. game Wildfire games (CC)
Es curioso, que ahora que está tan de moda la gamificación, y que además hace tiempo que se considera que los juegos permiten aprender técnicas y estrategias luego aplicables a la vida empresarial, no se recuerda algo que cualquier jugador de juegos de estrategia conoce:

En la mayoría de juegos de estrategia, la táctica ganadora pasa siempre por tener pocos soldados muy bien equipados y con mucha experiencia  (“caros”) y no en tener muchos  “baratos”. 

Y eso se lleva aplicando desde hace siglos al juego de estrategia por antonomasia, el ajedrez. Ningún jugador cambiaría una reina por dos o tres peones.

By User:Mutante [CC], from Wikimedia Commons


Como en otros casos, esperemos que una revisión crítica de los costes e impacto real de los “ahorros” en personal, al igual que he comentado respecto al material de trabajo  reconduzca la situación.


viernes, 16 de marzo de 2018

Por qué Bigdata no es para todo el mundo.

En estos últimos años ha “subido como la espuma” el interés por Bigdata. Parece que no hay empresa que no considere que debe invertir en Bigdata ni profesional que no considere que es un sector de futuro. Sin embargo, como indica el título de esta entrada, creo que Bigdata “no es para todos”, por su propia esencia.

By Magnai17 (Own work) [CC], via Wikimedia Commons


Repasando Bigdata.

Como es sabido, Bigdata (llamado en ocasiones Macrodatos en castellano) es un concepto que hace referencia a enormes volúmenes de datos, que no pueden ser tratados con las bases de datos tradicionales.
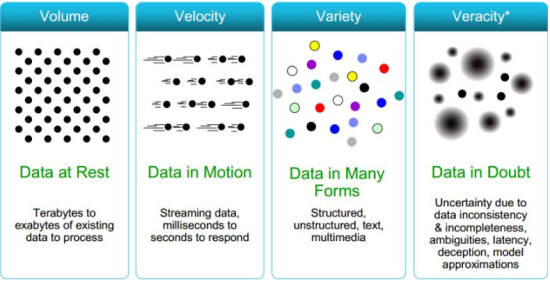
Los proyectos de Bigdata no solo se caracterizan por la cantidad de datos; tradicionalmente se ha definido que tienen tres características, las 3 V: Volumen, Velocidad, y Variedad.

  • Volumen hace referencia a la cantidad de los datos. Cuando se habla de Bigdata, estamos hablando de volúmenes MUY  grandes, de las decenas de TERAS en adelante, es decir hablamos de almacenar un mínimo de 10.000.000.000.000 caracteres. Los expertos en Bigdata suelen recomendar otras tecnologías para volúmenes inferiores, aunque sean “muy grandes”.  Para hacerse una idea de lo que implica, si pensamos que una llamada de teléfono se puede almacenar usando 11 dígitos del “llamante”+11 dígitos del llamado+5 de la duración+12 de la fecha hora, es decir 40 dígitos (realmente sería la mitad en base de datos, pero obviamos eso de momento) y dividimos 10Teras/40/50 Millones de habitantes, eso nos da que estaríamos hablando de 5.000 llamadas de cada habitante de España. Otra comparación podría ser el pensar en movimientos bancarios. Si contamos 50 caracteres por movimiento y pensando en un banco que tenga 10M de cuentas, nos da 20.000 movimientos (transferencias, entradas, etc.) de cada cuenta/cliente.
  • Velocidad hace referencia a la cantidad de datos que deben incorporarse por unidad de tiempo. Se trata de sistemas donde se puede generar cientos de miles de entrada por hora. Lógicamente, para alcanzar esos volúmenes no puede alimentarse con unos pocos registros cada hora, ya que se tardaría años en rellenarla la información.
  • Variedad hace referencia a la variedad de datos a manejar INCLUSO para la misma tabla/entidad. Es decir, no se trata de manejar 10 millones de asientos contables todos iguales sino de intentar manejar “juntos” elementos caracterizados por distintos metadatos.

Estos requerimientos han provocado que se utilicen tipos de herramientas distintas a los gestores de bases de datos tradicionales. Generalmente se utilizan Bases de Datos NoSQL como MongoDB , Cassandra o HBase  que utilizan un modelo no relacional .

El hecho de prescindir de la normalización de la base de datos  y de recursos habituales en las bases de datos “tradicionales” como transacciones (es decir poder agrupar las operaciones en paquetes de operaciones coherentes, de forma que se haga todo o nada), claves únicas (es decir asegurar que no se introduzca dos veces el mismo valor) o claves ajenas (que asegura que no se referencia una entrada que se borra por otra operación) elimina muchas de las sobrecargas sobre los sistemas  tradicionales, permitiendo velocidades de ingestión de los datos mucho mayores (al no tener que realizar comprobaciones de los valores), y una escalabilidad muy grande (al poder distribuirse la carga entre muchos nodos que no deben mantener la coherencia).

En cualquier caso, aunque no sean bases de datos “tradicionales” que tengan un modelo totalmente normalizado hasta la 3ª o 5º forma normal, siguen siendo bases de datos, es decir tiene una estructura de información, la diferencia es que podemos tener, por ejemplo, una factura con todos sus ítem en una “tabla”, algo que en un modelo normalizado requeriría dos o tres tablas.

En ocasiones surge cierta confusión en cuanto al uso, asumiendo que, por ejemplo, pueden utilizarse para clasificar textos, área para la que están mucho más preparadas herramientas como las herramientas de NLP (Natural Language Processing: Procesamiento del lenguaje natural), Machine Learning,  o Content Analytics. Ese sería otro ámbito de trabajo con otras características.


Courtesy NASA/JPL-Caltech [Attribution or Public domain], via Wikimedia Commons

Por qué no es para todas las empresas o instituciones.


La variedad de datos se da en muchos ámbitos y modelos que puedan realizarse de actividades humanas, sin embargo,

 ¿Cuántas actividades humanas generan esa cantidad de datos?

Y lo más importante

¿Cuántas empresas e instituciones tienen acceso, generan o reciben esa cantidad de información?

Como puede verse por las cifras, no es muy habitual manejar esa cantidad de información.
Y si se trata de cifras inferiores, NO es Bigdata, o NO es adecuado tratarlo con herramientas de Bigdata.
Debe además descontarse los escenarios donde se manejan millones de datos pero son texto (por lo que aplicarían las herramientas de manejo de textos antes citadas).

Por último un detalle menor.
Aunque después de frases famosas como la atribuida (incorrectamente ) a Bill Gates acerca de que “640K deben ser suficientes”  o la del presidente de IBM  Thomas J. Watson en 1948 de “Creo que habrá mercado mundial para cinco computadores” es muy “arriesgado” hacer previsiones, y aunque los costes de almacenamiento e infraestructura de ordenadores han bajado mucho y siguen bajando, a día de hoy manejar toda esa información de forma rápida y eficiente sigue siendo caro y complejo.

En cualquier caso es un obstáculo menor, que perderá cada vez más peso frente al problema principal de cualquier empresa o institución: ¿De dónde obtengo información que justifique el uso de Bigdata?


By Magnai17 (Own work) [CC], via Wikimedia Commons

Por qué no es para todos los profesionales.


En ocasiones se leen opiniones de profesionales que manejan otros tipo de información (contenidos, documentación, etc.) acerca de lo cercano o adecuado que es su perfil para volcarse en el mundo de Bigdata. Sin embargo, aunque sea un nuevo sector, no hay que olvidar que se trata de manejar bases/volúmenes de datos. No seguirán un modelo relacional, pero siguen un modelo, con sus columnas, conjuntos de metadatos, sus relaciones, su integridad mayor o menor, incluso sus transacciones (recientemente MongoDB ha cubierto esa carencia  ).
Quien no haya manejado esos conceptos, reflexionado sobre como optimizar un modelo de datos, crear índices o resolver problemas de rendimiento en una base de datos con 20 millones de registros, posiblemente no pueda sacar rendimiento de un proyecto de Bigdata.
Al igual que no es lo mismo un pintor que tras dominar el arte figurativo evoluciona hacia el abstracto que alguien que no sabe pintar y hace cuadros “abstractos”, no es lo mismo alguien que domina las bases de datos y evoluciona a Bigdata que  alguien que nunca ha trabajado con bases de datos.
Por supuesto todos podemos reciclarnos, formarnos y aprender nuevas disciplinas, al igual que puede haber expertos en bases de datos que se queden anclados y no sepan dar el paso a Bigdata (como puede ocurrir a un pintor que no sepa dar el paso a arte abstracto), solo quiero resaltar que, en principio, por su  experiencia y bagaje técnico, los profesionales especializados actualmente en bases de datos (administradores de bases de datos, diseñadores de bases de datos, expertos en data DataWarehouse, etc.), así como los expertos en análisis de datos y estadística son los que tendrán más facilidad para poder enfrentarse con proyectos de Bigdata.

Conclusión


Para no dejarse arrastrar por la ola de entusiasmo, creo que lo más recomendable para las empresas e instituciones, antes de plantearse iniciar un proyecto de Bigdata, sería reflexionar sobre:
  1. ¿Tengo en mis procesos y sistemas de información esos volúmenes de datos?
  2. Si se trata de información que no puede/debe tratarse con un modelo relacional ¿no bastaría plantearse el uso de una base de datos NoSQL con un modelo no normalizado?
Y para los profesionales que se plantean acercarse a ese mundo:
  1. ¿Pretendo CONOCER Bigdata (una disciplina nueva e interesante) o TRABAJAR en Bigdata?
  2. Si pretendo trabajar, ¿Mis conocimientos y los cursos que estoy evaluando son suficientemente profundos y adecuados?

jueves, 8 de febrero de 2018

La "Maldición" de la Gestión Documental.

Si a cualquiera se le cuenta que hay "ALGO" que TODAS las empresas e instituciones necesitan, o que, si no necesitan literalmente, de su uso obtienen unos enormes ahorros y eficiencias, creo que a los más emprendedores les surgiría la pregunta: “¿Qué es eso? Vamos a dedicarnos a ofrecerlo y nos ‘forramos’ ”.

Si además se añade que TAMBIÉN lo necesitan gran parte de los autónomos y que, una vez instalado, dadas las normativas o la dificultad de migración es posible que deba usarse un mínimo de 6 años y hasta 30 o 40 años, según a qué se dediquen la empresa o institución, la siguiente exclamación sería: “ ¡ Pero esto es la ‘gallina de los huevos de oro’ !, Millones de clientes potenciales que además del software necesitarán servicios añadidos durante años, y, dado que  produce grandes ahorros y eficiencias, se venderá muy bien, ya que enseguida recuperas la inversión. Las personas y empresas que se dediquen a esto deben estar muy solicitados”.

Por supuesto me refiero a la gestión documental (entendida como la implantación de procesos y herramientas que permitan registrar, almacenar, automatizar y compartir documentos), y no, tristemente la respuesta es que, aunque racionalmente debería haber mucho “movimiento” en torno al software y servicios de gestión documental, esta no se “vende” nada bien.

Las empresas e instituciones:
  • Pueden invertir miles de euros en aplicaciones o proyectos que no les reportan beneficios, mientras mantienen una gestión de la documentación del siglo XV; a nadie se le ocurre actualmente llevar la contabilidad o la gestión “a mano” y sin embargo la documentación se sigue manejando en papel y sin un gestor documental que la albergue; o los documentos electrónicos se envían por correo y se “guardan” en una carpeta de red.
  • Pueden cambiar cada 3 años de aplicación de contabilidad, ERP o nóminas cuando no tienen un solo software gestor documental para manejar los documentos electrónicos.
  • Pueden tener falta de espacio en las oficinas (con los enormes costes que ha ido alcanzando los alquileres) cuando podrían eliminar miles de papeles (en muchos casos fotocopias) simplemente digitalizando.
  • Siguen enviando los documentos en papel por medio de la valija interna (con los costes de transporte asociados) y retrasando los procesos hasta que se reciben los originales cuando podrían digitalizar, destruir las fotocopias y enviar los pocos originales a un centro de custodia situado “en medio del campo” y con costes mínimos.
Mientras tanto, no hay demasiadas empresas ni profesionales que se dediquen a ello, no hay demasiadas ofertas de empleo, los profesionales no están bien considerados y se cierran facultades y grados.

Y todo ello en un sector maduro tecnológicamente, donde existen muy buenos productos de gestión documental, tanto gestores documentales (el núcleo de la gestión documental) como herramientas de clasificación automática de documentos, conversión de formatos, procesos/BPM, gestión de expedientes, Record Management, motores de búsqueda por texto completo, etc.

Document-management-workflow (By Silver Blue)
Donde además de software con licencia comercial, hay software libre y/o gratuito, lo que, junto con la continua ampliación de la capacidad de almacenamiento y proceso de los ordenadores y abaratamiento de precios, permite que lo que hace años requería sistemas costosos y propietarios (como los Jukebox de discos ópticos) para almacenar imágenes, represente costes muy inferiores de puesta en marcha actualmente.

Parece como si hubiera una especie de “maldición” que hace que la gestión documental se mantenga en un agujero.

Dado que la idea de “maldición” repugna a cualquier espíritu racional, quería reflexionar sobre alguno de los posibles motivos que provocan este atasco. Como grandes razones, creo que puede resumirse en la combinación de tres factores:
  • Complejidad
  • Desconocimiento
  • Inercia


By KNOWLEDGE BASED SYSTEMS, INC. [Public domain], via Wikimedia Commons
 Complejidad:

Quizá el principal motivo es la complejidad. La gestión documental es MUY compleja en sí misma. Diseñar un proyecto de gestión documental tiene limitaciones y problemas que no tiene otros proyectos de tecnologías de la información:

Volumen: Abrir una cuenta en un banco o un siniestro enuna compañía de seguros puede representar unos pocos registros en una base de datos, totalizando 1000 o 2000 caracteres (1Kb o 2Kb). Sin embargo los documentos asociados a esa cuenta (contrato, DNI, Nómina, cartulina de firmas, documentos Mifid,..) o ese siniestro (fotos, grabación de audio, parte amistoso,..) pueden representar varios megas de información, es decir cerca de 1.000 (MIL) veces más de información, que hay que almacenar, clasificar y procesar. Eso representa un esfuerzo de dimensionamiento, infraestructura, diseño y rendimiento mucho mayor. Si además se desea buscar por el contenido de los documentos, deben crearse índices, lo que puede doblar el almacenamiento necesario, siendo entonces de 2.000 veces mayor. Ese volumen además de almacenarse debe subirse y descargarse en un tiempo razonable, lo que representa  un esfuerzo en infraestructura (servidores, ancho de banda, almacenamiento,..)

Legislación y normativa: Dado el carácter “legal” de muchos documentos (una entrada en una base de datos no demuestra nada, pero un contrato firmado, una carta o una grabación, sí) hay muchas normas que pueden aplicarse y que hay que tener en cuenta al diseñar el sistema. Como complicación adicional, hay documentos utilizados para un proceso que, aunque el proceso en sí pueda no ser complejo o confidencial, pueden arrastrar restricciones propias del documento. Por ejemplo, una declaración de la renta o una nómina, utilizada para abrir una cuenta, pedir un crédito o solicitar una plaza escolar, puede contener datos de desgravaciones por discapacidad, donaciones a un partido político o a una congregación religiosa, lo que podría considerarse como información cubierta por el nivel 3 de la L.O.P.D., y sujeta a unos procedimientos y tratamiento específicos. El caso, cada vez más frecuente, de los documentos electrónicos firmados electrónicamente o que contienen datos biométricos, estaría igualmente sujeto a una serie de restricciones, independientemente del contenido en sí del documento, que puede ser trivial.

Seguridad: La seguridad en los gestores documentales es muy sofisticada, para poder dar soporte a todos los condicionantes legales, así como a las necesidades propias del proceso de la institución (permisos restringidos en función del departamento o función del usuario, del estado o tipo documental del documento, traza de operaciones, control y bloqueo de versiones, etc...). El diseño y mantenimiento de esa seguridad (que además puede cambiar por normativas, reorganización o cambios de personal) es muy complicado.

Distribución: Al no estar aún legislada la validez de los documentos electrónicos, salvo excepciones en algunos ámbitos como la digitalización certificada de facturas, la mayoría de los intercambios de documentación entre empresas, instituciones y personas se sigue realizando en soporte papel. Esto implica que puede recibirse documentos en papelen diversos lugares, repartida por delegaciones y ciudades, lo que complica el diseño de los procesos. ¿Desplegar escáner por diversos puntos? ¿Enviar documentos a un centro de digitalización? ¿Quién y donde clasifica y asigna metadatos? Si quien asigna metadatos no es quien recibe el documento ¿Cómo se transmite esa información de la persona o expediente a que corresponde el documento, ya que podrían no estar en el propio documento?...

“Autoservicio”: Cada vez es más frecuente que los usuarios de un servicio, empresa o institución, puedan trabajar con un modelo de “autoservicio”, reservando viajes, abriendo cuentas, contratando seguros o declarando siniestros, y eso implica en muchos casos el suministro y descarga de documentos.  Que un usuario aporte sus documentos, por una parte elimina trabajos (no hay que digitalizar, registrar ni asociar el documento a un usuario o expediente) pero añade otras tareas y problemas asociados a este “autoservicio” (¿Qué ocurre si no se suministra el documento solicitado sino “una foto de las vacaciones”? ¿Y si el documento está caducado? ¿Y si está incompleto? ¿Y si esta borroso u oscuro y no es legible? ¿Y si es de otro usuario? ¿Y si el formato es obsoleto y no puede abrirse?...). El diseño de proyectos de este tipo implicará procesos más complejos de verificación, conversión, clasificación y extracción de metadatos, etc. Tareas todas ellas que pueden hacerse de forma manual o automática (existen productos que permiten hacerlo con muy buenos resultados) pero que en cualquier caso implican un proceso, infraestructura y software más complejos. A todo lo anterior, hay que añadir que el usuario cada vez tiene más acceso a su “expediente” de alguna forma (sea ante la Administración de Hacienda para ver las declaraciones, ante la operadora de telefonía o ante la compañía de seguros) lo que aumenta el número de usuarios del sistema desde unos pocos usuarios internos a miles de usuarios potenciales, con las implicaciones de seguridad, formación y rendimiento.

Múltiples formatos: A todo lo anterior, hay que añadir que los documentos pueden estar en múltiples formatos. Puede almacenarse un contrato como grabación de audio mp3, un parte de accidente puede contener un video como mp4 y desde luego podemos tener documentos en diversos formatos de imagen (tiff, png, jpg,..) o documentos ofimáticos (pdf, docx, odt, xls,..). Pero es que además, para “rizar el rizo”, cada uno de esos formatos suele tener múltiples variantes, como ha sufrido todo el mundo, al intentar abrir documentos ofimáticos (incluso con software del mismo fabricantes) que se distorsionan o no pueden abrirse, o al comprobar las múltiples variantes de codificación de ficheros del mismo formato/extensión, ya sea de audio, video o imagen. Esto obliga a un esfuerzo de conversión/normalización al recibir, visualizar o enviar, o incluso al procesar en las distintas piezas del proyecto (por ejemplo puede ocurrir que el escáner o dispositivo multifuncional solo genera imágenes tiff en formato lzw, el componente de clasificación REQUIERE tiff en codificación CCITT G4 y el programa de visualización REQUIERE tiff en codificación jpg).

Transversalidad: El último aspecto de la complejidad es la transversalidad. Otros proyectos tecnológicos pueden estar más acotados a un área o departamento, pero los proyectos de gestión documental, por su propia esencia, rápidamente se extienden e implican múltiples áreas (horizontales y verticales). Por ejemplo un proyecto de digitalización de expedientes afectará, por supuesto a la propia área implicada que maneja esos expedientes, pero también a Logística (al variar el volumen de papel almacenado al momento y en su caso al transporte o valija usado), a Seguridad (al tener que definir un modelo de seguridad nuevo), a Legal (ya que hay que revisar si los documentos están cubiertos por alguna normativa), a Marketing/comunicación (ya que si se diseña correctamente los documentos y formularios que genere la institución, puede automatizarse enormemente el tratamiento automático de los mismos cuando se reciben digitalizados, llegando incluso al 95% ) y  además a otras áreas, ya que lo más habitual es que se compartan documentos entre expedientes  de diversas áreas, que deben coordinarse por eficacia y eliminación de duplicidades.
Por ejemplo si se contrata un seguro de hogar y un seguro de automóvil, no tiene sentido que se solicite varias veces el documento de identidad y otros documentos, aunque la gestión la lleven diversas áreas, o el paradigma que se ha planteado repetidamente de que “la administración no debe pedir al ciudadano documentos que ya tenga de él”.

Es normal que, con todo lo anterior, los proyectos sean complejos y las herramientas sean complejas. Para poder realizar un buen diseño hace falta que tanto los profesionales que diseñan el sistema/servicio (ya sean internos o externos) como los usuarios que solicitan/adquieren el proyecto o actúan de patrocinadores del mismo, dominen el tema o al menos tengan una visión clara de su complejidad e implicaciones.

Lo que nos lleva al siguiente punto.


Desconocimiento:


Ante un escenario tan complejo, lo lógico sería acudir a especialistas y estudiar con detenimiento el problema y sus soluciones, sin embargo, todos manejamos documentos en papel, escribimos documentos ofimáticos, tomamos fotos y guardamos documentos en carpetas del ordenador, lo que crea una errónea sensación de dominio.
Empezando cronológicamente por el primer eslabón de la cadena, los usuarios de la entidad que requeriría el sistema, es habitual que se desconozca tanto las posibilidades técnicas que ofrecen las herramientas y tecnologías actuales, como las normativas aplicables o las recomendaciones y estándares internacionales. El resultado es que lo que se solicita en ocasiones no es lo que realmente necesita la entidad.
Esto se complementa con que en ocasiones la empresa que realizará el proyecto no aclara las dudas o alternativas y a veces directamente no propone la solución adecuada (ya sea por desconocimiento o por vender SU solución).
Si la empresa encargada del proyecto no cuenta con técnicos especialistas en gestión documental, es posible que, aunque cuente ton técnicos excepcionales, no construyan una buena solución debido a las complejidades antes indicadas, así como a la riqueza y complejidad de desarrollo de muchas de las herramientas.
Finalmente, el despliegue de las soluciones por parte de los administradores, debido a los volúmenes y rendimientos implicados, requiere un ajuste y dimensionamiento adecuado de los servidores e infraestructura, para lo que se requiere, de nuevo, cierta especialización.

Por supuesto que hay usuarios con las ideas muy claras y gran conocimiento de la gestión documental, buenas empresas con grandes técnicos, y administradores de los sistemas capaces de obtener buenos rendimientos, pero no es el caso mayoritario, y además no siempre coincide, de forma que aunque quien solicita una solución la especifique bien, no siempre se construye tal como se deseaba, o en ocasiones un técnico bien conocedor de la gestión documental se ve obligado a construir una solución poco adecuada por exigencias del usuario.


Inercia:


Finalmente, para acabar de crear la “tormenta perfecta” debemos contar con la inercia humana.
En lugar de aprovechar la implantación de una solución documental para hacer una reingeniería de los procesos y para aprovechar las posibilidades que ofrecen las diferentes herramientas, se suele trasladar un modelo existente, basado en papel, a un soporte electrónico. Lo que en ocasiones es incluso menos eficaz que el original.
Mientras, algunos ciclos universitarios de documentación siguen dedicando muchas más horas a asignaturas como "Paleografía"  o "Archivos Históricos", que a "Gestores Documentales", "Clasificación Automática de Documentos", "BPM" o "formatos de imágenes y documento", lo que no ayuda a enfrentarse a un proyectos cada vez más "tecnológicos" y complejos.
A ello se une la dificultad por parte de los usuarios finales de los sistemas a adaptarse al nuevo circuito, generalmente motivado por varias causas: Desconfianza del sistema, falta de formación, inercia en la forma de trabajo y mal diseño de los sistemas. Seguro que no soy el único que ha visto personas digitalizar expedientes e introducirlos en un circuito documental y ADEMAS hacer una fotocopia para “quedárselos por si hay problemas y no se encuentran o no se puede acceder al gestor documental”.
Sin una formación a los usuarios y participantes de todos los niveles y una gestión del cambio adecuada, incluso el proyecto mejor diseñado puede fracasar.


El triste resultado de la combinación de todos los factores anteriores es que la Gestión Documental sigue sin “arrancar” totalmente. Se llevan a cabo menos proyectos de lo que sería esperable y en muchos casos con una mala calidad que solo sirven para descorazonar a los usuarios y aplazar de nuevo.

Esperemos que este nuevo año 2018 traiga un príncipe o princesa que "bese" a la gestión documental, rompa la maldición y despierte a la gestión documental de ese sopor en que lleva tanto tiempo....
   :-)


viernes, 22 de diciembre de 2017

Reflexiones sobre las Metodologías Agiles

En estos últimos años, se ha ido extendiendo el modelo de desarrollo software llamado Metodología Agile o desarrollo ágil de software, en sus distintas variantes y enfoques: Kanban , Scrum o XP entre otros. Aunque muchos principios son antiguos, y algunos como la Programación Extrema (XP) se pusieron de moda hace años, ha sido últimamente cuando se ha desatado el “furor” por este modo de trabajo.

En el Manifiesto por el Desarrollo Ágil se resaltaron una serie de criterios y ponderaciones
  • Individuos e interacciones sobre procesos y herramientas
  • Software funcionando sobre documentación extensiva
  • Colaboración con el cliente sobre negociación contractual
  • Respuesta ante el cambio sobre seguir un plan
Que se plasman en 12 principios:
  1. Nuestra mayor prioridad es satisfacer al cliente mediante la entrega temprana y continua de software con valor.
  2. Aceptamos que los requisitos cambien, incluso en etapas tardías del desarrollo. Los procesos Ágiles aprovechan el cambio para proporcionar ventaja competitiva al cliente.
  3. Entregamos software funcional frecuentemente, entre dos semanas y dos meses, con preferencia al periodo de tiempo más corto posible.
  4. Los responsables de negocio y los desarrolladores trabajamos juntos de forma cotidiana durante todo el proyecto.
  5. Los proyectos se desarrollan en torno a individuos motivados. Hay que darles el entorno y el apoyo que necesitan, y confiarles la ejecución del trabajo.
  6. El método más eficiente y efectivo de comunicar información al equipo de desarrollo y entre sus miembros es la conversación cara a cara.
  7. El software funcionando es la medida principal de progreso.
  8. Los procesos Ágiles promueven el desarrollo sostenible. Los promotores, desarrolladores y usuarios debemos ser capaces de mantener un ritmo constante de forma indefinida.
  9. La atención continua a la excelencia técnica y al buen diseño mejora la Agilidad.
  10. La simplicidad, o el arte de maximizar la cantidad de trabajo no realizado, es esencial.
  11. Las mejores arquitecturas, requisitos y diseños emergen de equipos auto-organizados.
  12. A intervalos regulares el equipo reflexiona sobre cómo ser más efectivo para a continuación ajustar y perfeccionar su comportamiento en consecuencia.
By Dr ian mitchell (Own work) [CC BY-SA 3.0]

De forma muy simplificada, ¿qué se pretende conseguir?

Pues que en lugar de acordar con un cliente (interno o externo) un proyecto totalmente cerrado, que el cliente no ve hasta que han pasado muchos meses, descubriendo (con horror en algunos casos) en el momento de la entrega que no tiene nada que ver con lo que pensaba, se utiliza una aproximación gradual que el cliente/usuario puede ir siguiendo y orientando.

En lugar de un modelo jerárquico donde un jefe de proyecto o un analista transmite unas decisiones (que en algunos casos pueden ser erróneas), se utiliza un modelo cooperativo de trabajo en equipo, donde todo el mundo (incluido el usuario) aporta y se siente integrado, consiguiendo más calidad y productividad.

Y en lugar de perder demasiado tiempo documentando y actualizando documentación en algunos casos innecesaria, debe emplearse en hacer un código fuente claro y autodocumentado.

Personalmente pienso que el trabajo en equipo y la implicación de todos integrantes de un proyecto es un principio indiscutible, se use la metodología que se use. El tener en cuenta las opiniones de profesionales con distintos enfoques (programador, arquitecto, experto en base de datos, administrador,..) enriquece y permite detectar problemas y orientar mejor el proyecto, teniendo en cuenta la experiencia de cada perfil.

Igualmente la participación del cliente/usuario, evita un efecto “teléfono estropeado” donde el usuario cuenta lo que quiere a un técnico, que lo traduce para otro que lo transmite a otro, hasta que al final el programador implementa algo totalmente distinto.


También parece indiscutible, se use la metodología que se use, la efectividad de revisar el trabajo y el modo de desarrollo, buscando y aplicando mejoras al mismo (tanto a las soluciones como al modo de trabajo), lo que lleva años aplicándose en cadenas de montaje industriales de Japón con el nombre de Kaizen.

Sin embargo hay otros principios que aunque inicialmente parecen muy razonables, sin embargo pueden provocar problemas. Como en cualquier herramienta, disciplina o metodología, los problemas provienen de dos fuentes: mal uso de la metodología y problemas intrínsecos a la metodología, que en algunos casos se entremezclan.

Algunos problemas potenciales


Quizá el primero que surge es el de coste y plazos. Antes de empezar un proyecto debe conocerse su viabilidad y fechas de disponibilidad. Si el alcance (requisitos) y la solución no están muy cerrados no es posible conocer si el proyecto es viable ni si podrá entrar en producción en plazos. Por tanto, o se conocen (casi) todos los requisitos inicialmente (lo que choca con la “alegría” en “recibir requisitos en épocas tardías”), o son requisitos menores o se corre el riesgo de irse en plazos y costes tanto o más que en desarrollo “tradicional”.

Hay otro riesgo relacionado con el suministro gradual de requisitos. Como se citaba en el párrafo anterior, hay requisitos que pueden implicar más trabajo, pero hay requisitos que pueden implicar cambios sustanciales en la solución o herramientas usadas. Hace años las aplicaciones se desarrollaban en un lenguaje de programación u otro, almacenaban los datos en una base de datos y el grueso del trabajo era “programación” sin más. Pero los proyectos son cada vez más complejos, se exigen más funcionalidades, y los volúmenes son mayores. Esto ha provocado que raramente se desarrolle absolutamente todo desde cero. Lo habitual es que se utilicen framework de desarrollo, que se utilicen muchas librerías o bibliotecas  y que se integre múltiples productos y servidores en un solo proyecto. Los requisitos de “última hora” pueden provocar que se descubra que alguno de los lenguajes/productos/librerías/tecnologías elegidos no sirven porque no cubren esa función o no ofrecen el rendimiento esperado, lo que puede provocar:
  • el rehacer gran parte del desarrollo para integrar otro producto/librería,
  • el tener que comprar licencias de otro producto,
  • el requerir infraestructura y servidores que no estaban previstos,
Todo ello con los costes económicos y de plazos asociados.

Otro punto potencialmente peligroso es el de las “entregas periódicas”. Un proyecto medianamente complejo requiere normalmente la construcción (o selección) de marcos de trabajo, librerías, clases, etc. comunes a todo el proyecto y que luego facilitan el desarrollo y su calidad. Pero esos elementos iniciales en la mayoría de los casos son componentes muy “técnicos”, no son entregas “funcionales” por lo que puede ocurrir que los Sprint iniciales, o bien se hacen mucho más largos que el resto o bien la “revisión del proyecto” puede ser ver un fichero jar de java, que “no muestra nada” inteligible.

Quiero con ello resaltar la importancia de estas primeras fases en que se pone los cimientos y estructura del proyecto, y durante los cuales no hay nada que mostrar a un usuario no técnico. El forzar un desarrollo que muestre periódicamente “algo funcionando” puede llevar a desarrollos mal estructurados y mal enfocados, provocando el clásico desarrollo “espagueti” de Visual Basic que aunque muestra rápidamente pantallas, se hace imposible de mantener y propenso a errores al tener “todo conectado con todo”.

Finalmente, respecto la documentación, hay dos elementos “peligrosos”:
  • se debe dar prioridad a “software funcionando frente a documentación”.
  • “El método más eficiente y efectivo de comunicar información es la conversación…”,
Respecto al primero, si la documentación se toma como un “trámite” que se encarga al “becario”, el proyecto está condenado al fracaso a largo plazo (con cualquier metodología) ya que la documentación debe reflejar una visión clara y de alto nivel del proyecto de forma que en un futuro se entienda cómo funciona todo el sistema, qué se integra con qué, y porque se han tomado ciertas decisiones y no otras.

Desde luego documentar lo que un método o función hacen, puede documentarse en el Javadoc del mismo, no tiene sentido elaborar una documentación redundante y con riesgo de incoherencias o desactualización.

Pero muchas veces la documentación más importante NO está en el código fuente (entre otras cosas porque puede afectar a varios fuentes, a la forma de instalar un producto o de usar una librería o a otros elementos que no son el código fuente en sí). La documentación debe hacer referencia a la arquitectura general, la forma recomendada de uso, documentar porqué se optó por un producto o implementación. Sin esa información documentada adecuadamente, una segunda fase del proyecto (o la corrección de errores), que además podría incorporar un equipo nuevo, puede tomar decisiones incorrectas.

Respecto a la transmisión de información oral, evidentemente ayuda a explicar algunos aspectos y a debatir propuestas en modo “tormenta de ideas”, pero el escribirlas ayuda a formalizar y sistematizar las ideas y propuestas y formaliza el análisis y debate de los puntos, generando reuniones más eficaces. “Las palabras se las lleva el viendo”, y adicionalmente el texto escrito y formal permite evitar interpretaciones diferentes por distintos integrantes de un equipo.

En función de las reflexiones anteriores, podría deducirse que para proyectos donde el grueso está decidido (o incluso implementado) y queda pendiente el interfaz de usuario, o se trabaja sobre una nueva iteración, parece especialmente adecuado, mientras que para proyectos totalmente nuevos, con mucha indefinición funcional y tecnológica, el riesgo con una metodología ágil es mayor, especialmente si no se utiliza adecuadamente.

Como en cualquier herramienta (física o intelectual) debe utilizarse con criterio y analizando en cada caso los riesgos y necesidades. Al final, entre el blanco y el negro hay toda una gama de grises, y se debe elegir cual es el “color” adecuado, aplicando la metodología y los criterios de la forma adecuada y sin “fundamentalismos”.

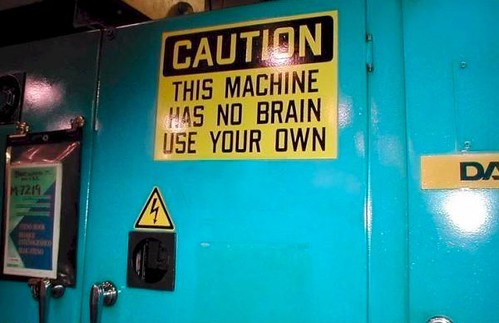
No Brain | by Pierre-Olivier


Como indicaba un letrero sobre una maquinaria pesada “CAUTION: This machine has no brain, use your own” (“Precaución: esta máquina no tiene cerebro, use el suyo propio”)

domingo, 22 de octubre de 2017

Los Microservicios NO son LA SOLUCIÓN


No, los Microservicios NO son "LA SOLUCIÓN" ni "valen para todo".


Estos dos últimos años se ha desatado una “locura” en torno a la Arquitectura de Microservicios, que ha “revolucionado” el modo de desarrollar y aparenta ser el “Bálsamo de Fierabrás” que “cura todas las dolencias”. Cualquier proyecto que no utilice Microservicios se considera automáticamente una “antigualla” y totalmente obsoleto  y erróneo. Me temo que debo disentir.

Como cualquier solución tecnológica, tiene sus ventajas e inconvenientes y sus ámbitos de aplicación.  Hay muchos escenarios para los que es una solución válida, pero no es aplicable automáticamente a todos los proyectos, ni siquiera a la mayoría, y además creo que el “entusiasmo” está haciendo no se evalúe adecuadamente sus desventajas, solo las ventajas. Para cualquier proyecto y escenario debe evaluarse con la mente abierta diversas soluciones, ponderar y medir ventajas e inconvenientes y sólo entonces elegir la mejor opción.

Creo que algunos sentimos una sensación de “Déjà vu” que hace recordar en cierto modo el entusiasmo en su momento con los Servicios Web, ahora rechazados frente al nuevo “juguete”. Ambos coinciden en ser una Arquitectura Orientada a Servicios, que prometía desacoplar los elementos de las aplicaciones, desarrollar aplicaciones más ligeras sin repetir código, desarrollar en distintos lenguajes y tecnologías y ofrecer un abanico servicios que por medio de una especie de diccionario/directorio, permitiría a las aplicaciones dinámicamente localizar el servicio web adecuado e invocarlo. ¿Suena conocido?

Antes de reflexionar sobre la Arquitectura de Microservicios, hay que destacar que su aparición ha coincidido con dos tecnologías/paradigmas muy importantes y útiles, un incremento de las posibilidades y oferta de virtualización (por medio de servicios como Amazon o Azure o por medio de “micro-máquinas virtuales” como Docker) y los modelos de integración continua y DevOps. Hay que tener en cuenta, que puede usarse microservicios sin esos elementos y que puede hacerse desarrollo “monolítico” con ellos, por tanto hay que centrarse exclusivamente en las características de los microservicios en sí mismos.

Otro punto previo a considerar es la simplificación planteada de “aplicación monolítica” frente a “aplicación basada en microservicios”. Creo que hace muchos años que no veo una aplicación totalmente monolítica y aislada. La mayor parte de las aplicaciones están distribuidas en varios servidores, invocan Servicios Web, leen de colas de mensajería, se integran con herramientas EAI, intercambian archivos con otros servidores del mismo proceso, etc. En cuanto a los microservicios, a pesar de su nombre no son exactamente “micro”. Según recomiendan los expertos, deben tener cierta coherencia funcional, por lo que no se trata simplemente de, por ejemplo, un servicio de “alta de un elemento”, ni siquiera de un servicio de mantenimiento (alta, baja y modificación) de elementos. Cada “servicio” puede consistir en varios métodos/funciones de diversa complejidad. Por tanto no se trata de comparar opción “monolítica - gigante” frente a opción “totalmente distribuida - micro” sino opción “poco distribuida con grandes bloques” frente a opción “muy distribuida con bloques pequeños”.

Para poder comparar ventajas e inconvenientes voy a plantear un proyecto hipotético a desarrollar en Java para desplegar en un servidor de aplicaciones, comparando las dos alternativas de arquitectura (monolítica vs microservicios) y revisando hasta qué punto son reales las “ventajas” de los MicroServicios. Supongamos un proyecto que consta de 4 bloques funcionales (susceptibles de convertirse cada uno en un micro servicio) con interrelaciones entre ellos. Para este escenario, se comparan las dos soluciones en tres aspectos principales:
  1. Diseño - Desarrollo,
  2. Despliegue - Infraestructura
  3. Explotación - Monitorización.


1- Diseño - Desarrollo.


 1-A) “Los microservicios permiten a trabajar a varios grupos de forma independientemente”.
Por supuesto, al igual que los paquetes, espacios de nombres, librerías o diversas técnicas existentes en la mayoría de los lenguajes ”serios”.
Dado que los métodos y parámetros entre bloques/servicios deben estar definidos en fases iniciales (en otro caso no podemos saber a qué se invoca ni con qué parámetros ya sea por medio de microservicios o métodos de clases) los 4 bloques funcionales podrían dividirse en 4 proyectos/paquetes/jar y trabajar en paralelo cuatro equipos, exactamente igual que 4 equipos podrían trabajar en los 4 microservicios. La diferencia principal sería que unos invocarían a otros llamando a métodos y clases y otros invocando microservicios remotos.

1-B) “Los microservicios permiten a trabajar en diversos lenguajes y tecnologías”.
Eso es cierto, aunque relativamente. Si necesitas invocar a otras tecnologías (ejemplo desde Java a servicios .Net) siempre puede utilizarse invocaciones REST, servicios Web o incluso JNI (https://es.wikipedia.org/wiki/Java_Native_Interface), aunque desde luego no siempre están disponibles todos los productos en esa forma. Además, para los principales lenguajes hay miles de librerías y APIs de productos.
Por último, el tener un equipo especializado en diversas tecnologías/lenguajes implica que si hay que mover técnicos de un servicio/bloque a otro puede no ser posible. Un equipo uniforme es más elástico.

1-C) “Los microservicios permiten tener BB.DD independientes para cada microservicio”.
Tradicionalmente las BB.DD. han incluido dos características vitales: La transaccionalidad (que nos permite realizar una serie de operaciones y, si todo es correcto, confirmarlas de forma que se haga todo o nada) y la integridad relacional (que asegura que no pueda referenciarse valores o códigos que no existen). Cuando se utiliza una BB.DD. con un modelo “completo”, la transaccionalidad e integridad está asegurada.
Si cada conjunto de tablas está separado y las operaciones se realizan invocando servicios, deberá gestionarse manualmente escenarios como que tras invocar una actualización o inserción de varias tablas, cuando uno de los servicios notifique que no se ha podido realizar la operación, deba deshacerse la operación. Para ello deberá implementarse en cada servicio una serie de métodos para deshacer cada una de las posibles operaciones del servicio (es decir, grosso modo se multiplica los métodos/servicios expuestos por 2).
Similarmente, debe gestionarse la integridad, es decir asegurar que cuando se inserta un registro, los valores referenciados (códigos de país, producto, cliente,…) existen o que antes de borrar se compruebe que nadie lo referencia. Esto no es trivial ya que, en situaciones de mucha concurrencia, entre la comprobación de existencia y la inserción, otra tarea puede borrar el registro referenciado, generando inconsistencias.

Veamos ahora los inconvenientes durante el desarrollo que en ocasiones se olvidan de los microservicios:

1-D) Control de tipos de parámetros: Cuando la comunicación entre bloques se hace utilizando un lenguaje (Java en este ejemplo), los cambios o control de tipo de dato (cadena, fecha, entero, etc.) se detectan en tiempo de compilación y son explícitos en la propia definición de los método y clases publicados. En los microservicios el intercambio de datos se hace en modo texto, por lo que debe convertirse todos los parámetros a texto y volverse a convertir al tipo físico al recibirlos. Esto no solo implica una sobrecarga de desarrollo sino un riesgo de errores, al poder depender de elementos locales a cada servidor como código de páginas (UTF-Windows 1252), formatos de fechas (dd/mm/aaaa, mm-dd-aaaa,…), decimales (123,4 – 123.4), etc.

1-E) Encapsulación: Cuando la comunicación entre bloques se hace utilizando un lenguaje (Java en este ejemplo), podemos recibir un objeto de un bloque/método, y pasarlo a otro sin necesidad de conocer la estructura, ya que la orientación a objetos nos asegura la encapsulación. Por ejemplo el bloque funcional de Contratación puede devolver en un método un objeto de clase Pedido y ese objeto pedido se transmite completo al bloque Almacen: Almacen.ActualizaInventario(Pedido1). Si se cambia la estructura (y el modelo de datos) de la clase Pedido, solo debe modificarse los componentes realmente afectados, no los intermedios. Con un modelo de MicroServicios, muchos elementos intermedios tendrían que modificarse para transmitir o leer todos los elementos de un Pedido. Esta encapsulación también afecta a otros aspectos de implementación y rendimiento. Por ejemplo, una invocación a un método Pedido.getItems() que devuelva la lista de elementos, puede implementarse para que devuelva a lista desde memoria (si estaban cargados previamente) o busque en la BB.DD. si no lo estaban). Con microservicios sería necesaria la invocación explícita al otro microservicio.

1-F) Sobrecarga de comunicaciones: La invocación a una clase o método dentro de un lenguaje es trivial. La invocación a otro microservicio, implica un código adicional (ya sea implementado directamente o utilizando un framework) que debe gestionar la conversión y emparejamiento de parámetros, la gestión de comunicaciones y timeout, reintentos, resolución de urls, etc.

1-G) Control de parámetros: Cuando la comunicación entre bloques se hace utilizando un lenguaje, si un método de un bloque funcional que admitía 2 parámetros se modifica para utilizar 3, esos cambios se detectan y saltan en tiempo de compilación. En el caso de los microservicios, hasta que no se invoque no se detecta el error.

2- Despliegue e infraestructura.


2-A) “Los microservicios son más ligeros”
Si repasamos las necesidades (obviando la alta disponibilidad, que implica duplicar todo en cualquiera de las dos arquitecturas), vemos que la aplicación monolítica requiere 1 sistema operativo + 1 máquina Java + servidor de aplicaciones + librerías comunes y de utilidad (driver jdbc, log4j, manejo XML, etc.) + cuatro módulos, lo que puede representarse como:

Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D
Librerías comunes
Servidor Aplicaciones
JVM
Sistema Operativo

La versión basada en microservicios requerirá 4 * [ 1 sistema operativo + 1 máquina Java + servidor de aplicaciones + librerías comunes y de utilidad (driver jdbc, log4j, manejo XML, etc.)+ 1 módulo + elementos adicionales comentados (comunicaciones, formateo y comprobación datos entrada/salida, cancelación transacciones)  ], por lo que podría representarse:

Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D
Librerías comunes
Librerías comunes
Librerías comunes
Librerías comunes
Servidor Aplicaciones
JVM
JVM
JVM
JVM
Sistema Operativo
Sistema Operativo
Sistema Operativo
Sistema Operativo

Es decir, en el caso muy simplificado de que todos los bloques fueran iguales (caso no real, ya que el S.O., JVM y servidor de aplicaciones son mucho más grandes que los bloques funcionales) se trata de 8 bloques/unidades de memoria (y puede equipararse a consumo de CPU para procesar y manejar esa información), frente a 24 bloques, es decir 3 veces más de infraestructura necesaria (en memoria y CPU).
Si estuviéramos hablando de, por ejemplo 10 microservicios/bloques funcionales, la comparación sería de 14 frente a 60 “unidades”.

Y si consideramos tamaños diferentes de cada bloque y un poco más reales de sistema operativo (incluso en sistemas Docker), tamaños de JVM y servidor de aplicaciones (servidores de aplicaciones miniatura como Jetty) frente a tamaño de microservicios, incluso en el caso de 4 bloques, la comparación es de:

Bloque/Servicio A 20M
Bloque/Servicio B 20M
Bloque/Servicio C 20M
Bloque/Servicio D 20M
Librerías comunes 50M
Servidor Aplicaciones 100M
JVM 100M
Sistema Operativo 500M


830M frente a 3160M o en el caso de 10 microservicios, 950M frente a 7.900M es decir un coste en infraestructura entre 4 y 8 veces mayor (y con otros tamaños de S.O y servidor de aplicaciones, incluso 10 o 15 veces mayor).

2-B) “Los microservicios son más fácilmente escalables”

Suele argumentarse que en el caso de los microservicios el escalado es más fácil, ya que puede desplegarse más instancias del servicio más usado. Es decir si el bloque A es invocado más veces que el resto, podría desplegarse dos instancias/instalaciones del microservicio A y una para cada una del resto, es decir algo como:

Bloque/Servicio A
Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D

Sin entrar en los costes, ya revisados, hay algo sorprendente en la afirmación. Si se despliega un servicio/bloque en un servidor, ese servidor únicamente puede ejecutar esa tarea. Es decir una instalación dimensionada para atender 4 peticiones simultáneas de servicios A, solo podrá atender esas 4 peticiones:


A
A

B
B

C
C

D
D
A
A

B


D
D


Si se recibe 6 peticiones de tipo A o 5 de tipo D, no podrán atenderse

Un servidor donde se haya desplegado todos los paquetes, dimensionado para atender 16 peticiones, atenderá cualquier petición de cualquier tipo (A, B, C o D) hasta su máximo de recursos

A A A B
A A A B
B C C D
D D D D


O lo que de forma doméstica puede expresarse como “en un cajón grande tienes más flexibilidad que en 4 cajones pequeños”. Por supuesto que pueden desplegarse más instancias para atender al servicio A, pero en la opción monolítica no sería necesario, al margen de los costes de infraestructura antes citados.

2-C) “En caso de caída de un microservicio, el resto puede seguir funcionando”
Me sorprende que tras años de existencia de sistemas de tolerancia a fallos, granjas de servidores, tecnologías cluster, alta disponibilidad Activo/Activo y Activo/pasivo, y disponibilidades predicadas del 99, 99% del tiempo, se plantee que se puede “no disponer” de una aplicación. Pero incluso si fuera el caso, plantear que “si se cae un microservicio el resto siguen funcionando” es algo bastante discutible. Si se trata, por ejemplo, de una contratación y no se puede acceder al servicio de “clientes”, o al servicio de “almacén”, o la “pasarela de pago”, no podrá realizarse esa contratación. La aplicación tiene generalmente una coherencia y unos servicios interconectados. Si uno de ellos se cae, probablemente no pueda realizarse la mayor parte de las operaciones, y en muchos casos, ninguna.

2-D) “Puede desplegarse nuevas versiones de los microservicios de forma independiente”
Habría que distinguir lo primero a que llamamos “nuevas versiones”.  Si se trata de desplegar una corrección de un error o una optimización, por supuesto puede hacerse de forma independiente, al igual que puede hacerse también en una aplicación monolítica sustituyendo el fichero java jar correspondiente. Si se trata de una NUEVA versión, que expone un “contrato” nuevo (con diferentes parámetros, un comportamiento distinto, métodos adicionales,..) desde luego deberá desplegarse y probarse de forma conjunta. En otro caso, se está invocando a operaciones cuyo comportamiento es distinto (aunque no lo sea el “contrato” expuesto). El concepto de “pruebas de integración” existe hace mucho años, tanto en aplicaciones monolíticas como en las que no lo son, debido a que en cuanto hay que integrar varios sistemas, existen riesgos y comportamiento no perfectamente documentados (autenticación entre sistemas, códigos de página, tamaños de bloque, límites en cuanto a número de parámetros. Comportamiento ante excepciones, timeout, etc.)

2-E) Comunicaciones: Por último, hay algo que parece olvidarse, la comunicación entre servidores y microservicios tiene un coste de infraestructura, no es gratis. Y si se trata de un entorno en nube, podemos incluso consultar los precios de transferencias internas y externas (https://aws.amazon.com/es/ec2/pricing/on-demand/). Por tanto el uso de microservicios tiene además ese sobrecoste por el hecho de estar intercambiando información entre servidores que no se produce en la opción monolítica.


 3- Administración Monitorización


Respecto a este punto, podría revisarse 3 aspectos:

A) Instalación y actualización (de Sistema Operativo, servidor de aplicaciones, utilidades y por supuesto aplicación).
B) Monitorización (debe controlarse el estado de memoria, CPU y disco de los servidores, así como el estado del servidor de aplicaciones y de la aplicación en sí).
C) Depuración y monitorización del proceso/BAM (es decir tanto depurar y analizar problemas de la aplicación como analizar en tiempo real el estado de un proceso de negocio.

3-A) En el primer caso, parece evidente que, de instalar y configurar un servidor (virtual o no) y una aplicación, hemos multiplicado el trabajo por el número de microservicios del proyecto (por supuesto la alta disponibilidad multiplica en ambos casos por dos). Lo mismo aplica para las actualizaciones y parches de seguridad o fixpack de microservicios, librerías o S.O. Desde luego, con plataformas como Docker esto se simplifica, y el número de tareas manuales se reduce, pero esto también aplica a la opción monolítica. El hecho es que sean muchas o pocas las tareas y pruebas de regresión, hay que multiplicarlas por el número de microservicios.

3-B) La monitorización de los servidores y la infraestructura (que siempre es necesaria para controlar problemas de lentitud, memoria o disco) se multiplica igualmente por el número de microservicios desplegados. No me refiero solo a caídas del sistema (que es casi lo más automatizable) sino verificar que los tiempos de respuesta son adecuados, que el nivel de uso de la CPU no sea del 99% o que la memoria libre de RAM o la de almacenamiento estén por encima de unos valores.

3-C) En cuanto a la depuración, desde luego el analizar un problema recurriendo a 4 (o N) ficheros de traza “paralelos” es mucho más complicado que disponer de un solo fichero donde se vea la secuencia y la lógica de las distintas operaciones. En cuanto a la monitorización de procesos, a nivel funcional y de cuadro de mando, también se complica más al contar con 4 (o N) elementos separados.


Conclusión.


La conclusión no es que los microservicios no sean una solución válida, la conclusión es que no son LA SOLUCIÓN a aplicar automáticamente en todos los casos ni son siempre la mejor opción.

Son una opción más a aplicar cuando las características del proyecto sean las adecuadas, a comparar en pie de igualdad con muchas otras, incluyendo, por supuesto, un desarrollo “monolítico”.