domingo, 22 de octubre de 2017

Los Microservicios NO son LA SOLUCIÓN


No, los Microservicios NO son "LA SOLUCIÓN" ni "valen para todo".


Estos dos últimos años se ha desatado una “locura” en torno a la Arquitectura de Microservicios, que ha “revolucionado” el modo de desarrollar y aparenta ser el “Bálsamo de Fierabrás” que “cura todas las dolencias”. Cualquier proyecto que no utilice Microservicios se considera automáticamente una “antigualla” y totalmente obsoleto  y erróneo. Me temo que debo disentir.

Como cualquier solución tecnológica, tiene sus ventajas e inconvenientes y sus ámbitos de aplicación.  Hay muchos escenarios para los que es una solución válida, pero no es aplicable automáticamente a todos los proyectos, ni siquiera a la mayoría, y además creo que el “entusiasmo” está haciendo no se evalúe adecuadamente sus desventajas, solo las ventajas. Para cualquier proyecto y escenario debe evaluarse con la mente abierta diversas soluciones, ponderar y medir ventajas e inconvenientes y sólo entonces elegir la mejor opción.

Creo que algunos sentimos una sensación de “Déjà vu” que hace recordar en cierto modo el entusiasmo en su momento con los Servicios Web, ahora rechazados frente al nuevo “juguete”. Ambos coinciden en ser una Arquitectura Orientada a Servicios, que prometía desacoplar los elementos de las aplicaciones, desarrollar aplicaciones más ligeras sin repetir código, desarrollar en distintos lenguajes y tecnologías y ofrecer un abanico servicios que por medio de una especie de diccionario/directorio, permitiría a las aplicaciones dinámicamente localizar el servicio web adecuado e invocarlo. ¿Suena conocido?

Antes de reflexionar sobre la Arquitectura de Microservicios, hay que destacar que su aparición ha coincidido con dos tecnologías/paradigmas muy importantes y útiles, un incremento de las posibilidades y oferta de virtualización (por medio de servicios como Amazon o Azure o por medio de “micro-máquinas virtuales” como Docker) y los modelos de integración continua y DevOps. Hay que tener en cuenta, que puede usarse microservicios sin esos elementos y que puede hacerse desarrollo “monolítico” con ellos, por tanto hay que centrarse exclusivamente en las características de los microservicios en sí mismos.

Otro punto previo a considerar es la simplificación planteada de “aplicación monolítica” frente a “aplicación basada en microservicios”. Creo que hace muchos años que no veo una aplicación totalmente monolítica y aislada. La mayor parte de las aplicaciones están distribuidas en varios servidores, invocan Servicios Web, leen de colas de mensajería, se integran con herramientas EAI, intercambian archivos con otros servidores del mismo proceso, etc. En cuanto a los microservicios, a pesar de su nombre no son exactamente “micro”. Según recomiendan los expertos, deben tener cierta coherencia funcional, por lo que no se trata simplemente de, por ejemplo, un servicio de “alta de un elemento”, ni siquiera de un servicio de mantenimiento (alta, baja y modificación) de elementos. Cada “servicio” puede consistir en varios métodos/funciones de diversa complejidad. Por tanto no se trata de comparar opción “monolítica - gigante” frente a opción “totalmente distribuida - micro” sino opción “poco distribuida con grandes bloques” frente a opción “muy distribuida con bloques pequeños”.

Para poder comparar ventajas e inconvenientes voy a plantear un proyecto hipotético a desarrollar en Java para desplegar en un servidor de aplicaciones, comparando las dos alternativas de arquitectura (monolítica vs microservicios) y revisando hasta qué punto son reales las “ventajas” de los MicroServicios. Supongamos un proyecto que consta de 4 bloques funcionales (susceptibles de convertirse cada uno en un micro servicio) con interrelaciones entre ellos. Para este escenario, se comparan las dos soluciones en tres aspectos principales:
  1. Diseño - Desarrollo,
  2. Despliegue - Infraestructura
  3. Explotación - Monitorización.


1- Diseño - Desarrollo.


 1-A) “Los microservicios permiten a trabajar a varios grupos de forma independientemente”.
Por supuesto, al igual que los paquetes, espacios de nombres, librerías o diversas técnicas existentes en la mayoría de los lenguajes ”serios”.
Dado que los métodos y parámetros entre bloques/servicios deben estar definidos en fases iniciales (en otro caso no podemos saber a qué se invoca ni con qué parámetros ya sea por medio de microservicios o métodos de clases) los 4 bloques funcionales podrían dividirse en 4 proyectos/paquetes/jar y trabajar en paralelo cuatro equipos, exactamente igual que 4 equipos podrían trabajar en los 4 microservicios. La diferencia principal sería que unos invocarían a otros llamando a métodos y clases y otros invocando microservicios remotos.

1-B) “Los microservicios permiten a trabajar en diversos lenguajes y tecnologías”.
Eso es cierto, aunque relativamente. Si necesitas invocar a otras tecnologías (ejemplo desde Java a servicios .Net) siempre puede utilizarse invocaciones REST, servicios Web o incluso JNI (https://es.wikipedia.org/wiki/Java_Native_Interface), aunque desde luego no siempre están disponibles todos los productos en esa forma. Además, para los principales lenguajes hay miles de librerías y APIs de productos.
Por último, el tener un equipo especializado en diversas tecnologías/lenguajes implica que si hay que mover técnicos de un servicio/bloque a otro puede no ser posible. Un equipo uniforme es más elástico.

1-C) “Los microservicios permiten tener BB.DD independientes para cada microservicio”.
Tradicionalmente las BB.DD. han incluido dos características vitales: La transaccionalidad (que nos permite realizar una serie de operaciones y, si todo es correcto, confirmarlas de forma que se haga todo o nada) y la integridad relacional (que asegura que no pueda referenciarse valores o códigos que no existen). Cuando se utiliza una BB.DD. con un modelo “completo”, la transaccionalidad e integridad está asegurada.
Si cada conjunto de tablas está separado y las operaciones se realizan invocando servicios, deberá gestionarse manualmente escenarios como que tras invocar una actualización o inserción de varias tablas, cuando uno de los servicios notifique que no se ha podido realizar la operación, deba deshacerse la operación. Para ello deberá implementarse en cada servicio una serie de métodos para deshacer cada una de las posibles operaciones del servicio (es decir, grosso modo se multiplica los métodos/servicios expuestos por 2).
Similarmente, debe gestionarse la integridad, es decir asegurar que cuando se inserta un registro, los valores referenciados (códigos de país, producto, cliente,…) existen o que antes de borrar se compruebe que nadie lo referencia. Esto no es trivial ya que, en situaciones de mucha concurrencia, entre la comprobación de existencia y la inserción, otra tarea puede borrar el registro referenciado, generando inconsistencias.

Veamos ahora los inconvenientes durante el desarrollo que en ocasiones se olvidan de los microservicios:

1-D) Control de tipos de parámetros: Cuando la comunicación entre bloques se hace utilizando un lenguaje (Java en este ejemplo), los cambios o control de tipo de dato (cadena, fecha, entero, etc.) se detectan en tiempo de compilación y son explícitos en la propia definición de los método y clases publicados. En los microservicios el intercambio de datos se hace en modo texto, por lo que debe convertirse todos los parámetros a texto y volverse a convertir al tipo físico al recibirlos. Esto no solo implica una sobrecarga de desarrollo sino un riesgo de errores, al poder depender de elementos locales a cada servidor como código de páginas (UTF-Windows 1252), formatos de fechas (dd/mm/aaaa, mm-dd-aaaa,…), decimales (123,4 – 123.4), etc.

1-E) Encapsulación: Cuando la comunicación entre bloques se hace utilizando un lenguaje (Java en este ejemplo), podemos recibir un objeto de un bloque/método, y pasarlo a otro sin necesidad de conocer la estructura, ya que la orientación a objetos nos asegura la encapsulación. Por ejemplo el bloque funcional de Contratación puede devolver en un método un objeto de clase Pedido y ese objeto pedido se transmite completo al bloque Almacen: Almacen.ActualizaInventario(Pedido1). Si se cambia la estructura (y el modelo de datos) de la clase Pedido, solo debe modificarse los componentes realmente afectados, no los intermedios. Con un modelo de MicroServicios, muchos elementos intermedios tendrían que modificarse para transmitir o leer todos los elementos de un Pedido. Esta encapsulación también afecta a otros aspectos de implementación y rendimiento. Por ejemplo, una invocación a un método Pedido.getItems() que devuelva la lista de elementos, puede implementarse para que devuelva a lista desde memoria (si estaban cargados previamente) o busque en la BB.DD. si no lo estaban). Con microservicios sería necesaria la invocación explícita al otro microservicio.

1-F) Sobrecarga de comunicaciones: La invocación a una clase o método dentro de un lenguaje es trivial. La invocación a otro microservicio, implica un código adicional (ya sea implementado directamente o utilizando un framework) que debe gestionar la conversión y emparejamiento de parámetros, la gestión de comunicaciones y timeout, reintentos, resolución de urls, etc.

1-G) Control de parámetros: Cuando la comunicación entre bloques se hace utilizando un lenguaje, si un método de un bloque funcional que admitía 2 parámetros se modifica para utilizar 3, esos cambios se detectan y saltan en tiempo de compilación. En el caso de los microservicios, hasta que no se invoque no se detecta el error.

2- Despliegue e infraestructura.


2-A) “Los microservicios son más ligeros”
Si repasamos las necesidades (obviando la alta disponibilidad, que implica duplicar todo en cualquiera de las dos arquitecturas), vemos que la aplicación monolítica requiere 1 sistema operativo + 1 máquina Java + servidor de aplicaciones + librerías comunes y de utilidad (driver jdbc, log4j, manejo XML, etc.) + cuatro módulos, lo que puede representarse como:

Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D
Librerías comunes
Servidor Aplicaciones
JVM
Sistema Operativo

La versión basada en microservicios requerirá 4 * [ 1 sistema operativo + 1 máquina Java + servidor de aplicaciones + librerías comunes y de utilidad (driver jdbc, log4j, manejo XML, etc.)+ 1 módulo + elementos adicionales comentados (comunicaciones, formateo y comprobación datos entrada/salida, cancelación transacciones)  ], por lo que podría representarse:

Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D
Librerías comunes
Librerías comunes
Librerías comunes
Librerías comunes
Servidor Aplicaciones
JVM
JVM
JVM
JVM
Sistema Operativo
Sistema Operativo
Sistema Operativo
Sistema Operativo

Es decir, en el caso muy simplificado de que todos los bloques fueran iguales (caso no real, ya que el S.O., JVM y servidor de aplicaciones son mucho más grandes que los bloques funcionales) se trata de 8 bloques/unidades de memoria (y puede equipararse a consumo de CPU para procesar y manejar esa información), frente a 24 bloques, es decir 3 veces más de infraestructura necesaria (en memoria y CPU).
Si estuviéramos hablando de, por ejemplo 10 microservicios/bloques funcionales, la comparación sería de 14 frente a 60 “unidades”.

Y si consideramos tamaños diferentes de cada bloque y un poco más reales de sistema operativo (incluso en sistemas Docker), tamaños de JVM y servidor de aplicaciones (servidores de aplicaciones miniatura como Jetty) frente a tamaño de microservicios, incluso en el caso de 4 bloques, la comparación es de:

Bloque/Servicio A 20M
Bloque/Servicio B 20M
Bloque/Servicio C 20M
Bloque/Servicio D 20M
Librerías comunes 50M
Servidor Aplicaciones 100M
JVM 100M
Sistema Operativo 500M


830M frente a 3160M o en el caso de 10 microservicios, 950M frente a 7.900M es decir un coste en infraestructura entre 4 y 8 veces mayor (y con otros tamaños de S.O y servidor de aplicaciones, incluso 10 o 15 veces mayor).

2-B) “Los microservicios son más fácilmente escalables”

Suele argumentarse que en el caso de los microservicios el escalado es más fácil, ya que puede desplegarse más instancias del servicio más usado. Es decir si el bloque A es invocado más veces que el resto, podría desplegarse dos instancias/instalaciones del microservicio A y una para cada una del resto, es decir algo como:

Bloque/Servicio A
Bloque/Servicio A
Bloque/Servicio B
Bloque/Servicio C
Bloque/Servicio D

Sin entrar en los costes, ya revisados, hay algo sorprendente en la afirmación. Si se despliega un servicio/bloque en un servidor, ese servidor únicamente puede ejecutar esa tarea. Es decir una instalación dimensionada para atender 4 peticiones simultáneas de servicios A, solo podrá atender esas 4 peticiones:


A
A

B
B

C
C

D
D
A
A

B


D
D


Si se recibe 6 peticiones de tipo A o 5 de tipo D, no podrán atenderse

Un servidor donde se haya desplegado todos los paquetes, dimensionado para atender 16 peticiones, atenderá cualquier petición de cualquier tipo (A, B, C o D) hasta su máximo de recursos

A A A B
A A A B
B C C D
D D D D


O lo que de forma doméstica puede expresarse como “en un cajón grande tienes más flexibilidad que en 4 cajones pequeños”. Por supuesto que pueden desplegarse más instancias para atender al servicio A, pero en la opción monolítica no sería necesario, al margen de los costes de infraestructura antes citados.

2-C) “En caso de caída de un microservicio, el resto puede seguir funcionando”
Me sorprende que tras años de existencia de sistemas de tolerancia a fallos, granjas de servidores, tecnologías cluster, alta disponibilidad Activo/Activo y Activo/pasivo, y disponibilidades predicadas del 99, 99% del tiempo, se plantee que se puede “no disponer” de una aplicación. Pero incluso si fuera el caso, plantear que “si se cae un microservicio el resto siguen funcionando” es algo bastante discutible. Si se trata, por ejemplo, de una contratación y no se puede acceder al servicio de “clientes”, o al servicio de “almacén”, o la “pasarela de pago”, no podrá realizarse esa contratación. La aplicación tiene generalmente una coherencia y unos servicios interconectados. Si uno de ellos se cae, probablemente no pueda realizarse la mayor parte de las operaciones, y en muchos casos, ninguna.

2-D) “Puede desplegarse nuevas versiones de los microservicios de forma independiente”
Habría que distinguir lo primero a que llamamos “nuevas versiones”.  Si se trata de desplegar una corrección de un error o una optimización, por supuesto puede hacerse de forma independiente, al igual que puede hacerse también en una aplicación monolítica sustituyendo el fichero java jar correspondiente. Si se trata de una NUEVA versión, que expone un “contrato” nuevo (con diferentes parámetros, un comportamiento distinto, métodos adicionales,..) desde luego deberá desplegarse y probarse de forma conjunta. En otro caso, se está invocando a operaciones cuyo comportamiento es distinto (aunque no lo sea el “contrato” expuesto). El concepto de “pruebas de integración” existe hace mucho años, tanto en aplicaciones monolíticas como en las que no lo son, debido a que en cuanto hay que integrar varios sistemas, existen riesgos y comportamiento no perfectamente documentados (autenticación entre sistemas, códigos de página, tamaños de bloque, límites en cuanto a número de parámetros. Comportamiento ante excepciones, timeout, etc.)

2-E) Comunicaciones: Por último, hay algo que parece olvidarse, la comunicación entre servidores y microservicios tiene un coste de infraestructura, no es gratis. Y si se trata de un entorno en nube, podemos incluso consultar los precios de transferencias internas y externas (https://aws.amazon.com/es/ec2/pricing/on-demand/). Por tanto el uso de microservicios tiene además ese sobrecoste por el hecho de estar intercambiando información entre servidores que no se produce en la opción monolítica.


 3- Administración Monitorización


Respecto a este punto, podría revisarse 3 aspectos:

A) Instalación y actualización (de Sistema Operativo, servidor de aplicaciones, utilidades y por supuesto aplicación).
B) Monitorización (debe controlarse el estado de memoria, CPU y disco de los servidores, así como el estado del servidor de aplicaciones y de la aplicación en sí).
C) Depuración y monitorización del proceso/BAM (es decir tanto depurar y analizar problemas de la aplicación como analizar en tiempo real el estado de un proceso de negocio.

3-A) En el primer caso, parece evidente que, de instalar y configurar un servidor (virtual o no) y una aplicación, hemos multiplicado el trabajo por el número de microservicios del proyecto (por supuesto la alta disponibilidad multiplica en ambos casos por dos). Lo mismo aplica para las actualizaciones y parches de seguridad o fixpack de microservicios, librerías o S.O. Desde luego, con plataformas como Docker esto se simplifica, y el número de tareas manuales se reduce, pero esto también aplica a la opción monolítica. El hecho es que sean muchas o pocas las tareas y pruebas de regresión, hay que multiplicarlas por el número de microservicios.

3-B) La monitorización de los servidores y la infraestructura (que siempre es necesaria para controlar problemas de lentitud, memoria o disco) se multiplica igualmente por el número de microservicios desplegados. No me refiero solo a caídas del sistema (que es casi lo más automatizable) sino verificar que los tiempos de respuesta son adecuados, que el nivel de uso de la CPU no sea del 99% o que la memoria libre de RAM o la de almacenamiento estén por encima de unos valores.

3-C) En cuanto a la depuración, desde luego el analizar un problema recurriendo a 4 (o N) ficheros de traza “paralelos” es mucho más complicado que disponer de un solo fichero donde se vea la secuencia y la lógica de las distintas operaciones. En cuanto a la monitorización de procesos, a nivel funcional y de cuadro de mando, también se complica más al contar con 4 (o N) elementos separados.


Conclusión.


La conclusión no es que los microservicios no sean una solución válida, la conclusión es que no son LA SOLUCIÓN a aplicar automáticamente en todos los casos ni son siempre la mejor opción.

Son una opción más a aplicar cuando las características del proyecto sean las adecuadas, a comparar en pie de igualdad con muchas otras, incluyendo, por supuesto, un desarrollo “monolítico”.

viernes, 1 de septiembre de 2017

El corazón de las tinieblas


Con este título no quiero hablar hoy sobre la famosa novela de Joseph Konrad  (que por cierto acabo de releer en versión bilingüe, lo que permite disfrutar mucho más la riqueza del inglés de Konrad) y que inspiró la película Apocalipse Now; sino reflexionar en un tono ligero, como suele corresponder tradicionalmente a los medios de comunicación en verano, sobre los interfaces de usuario utilizados últimamente por muchos programadores y personas implicadas en el desarrollo de aplicaciones.

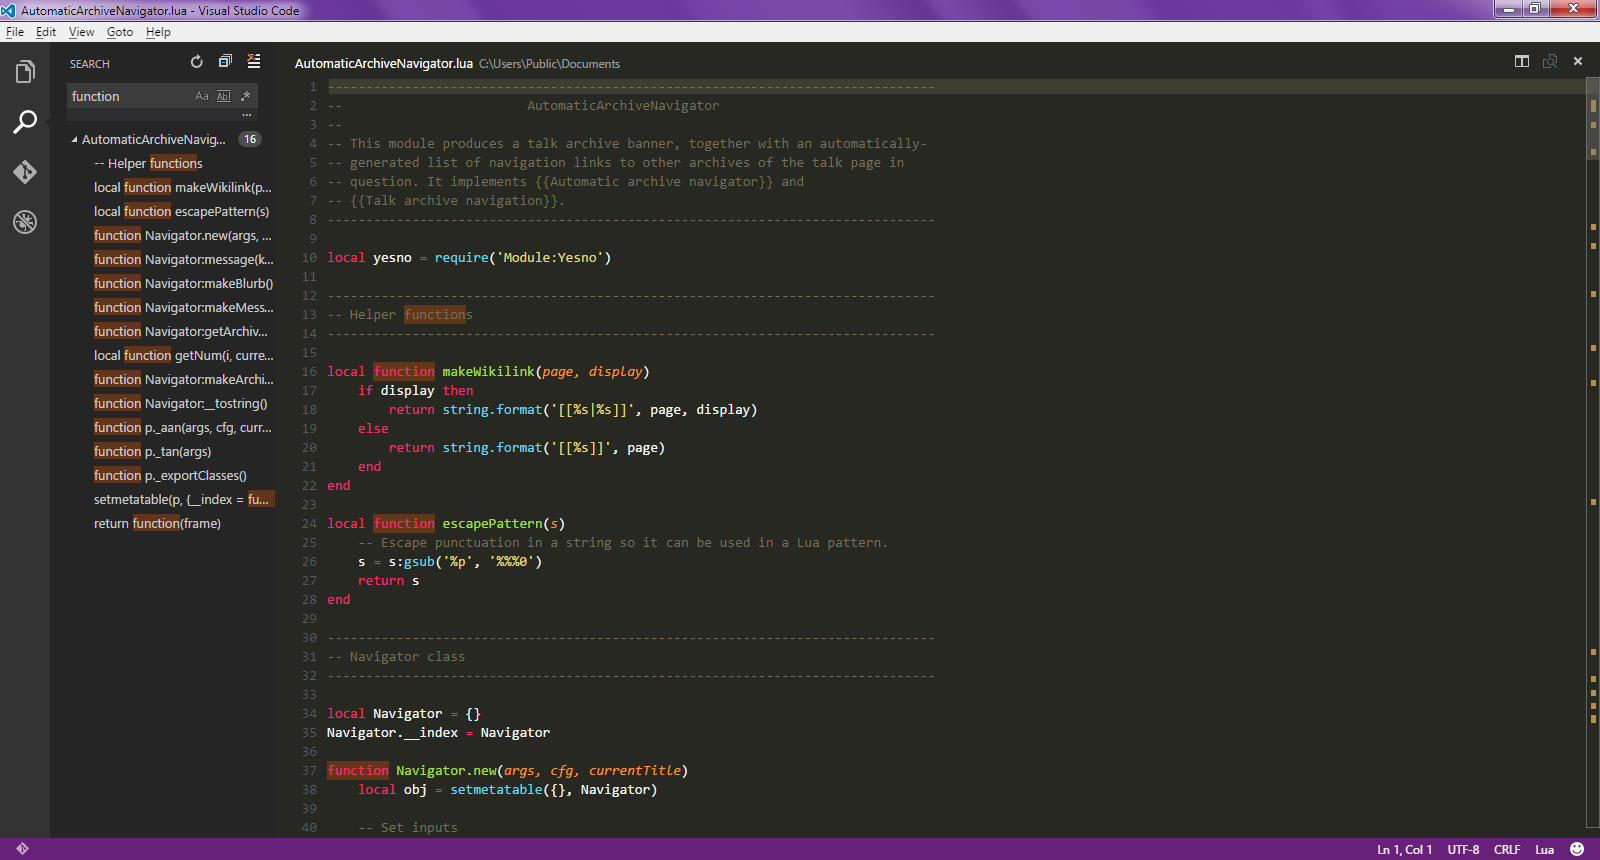
Si comparamos las siguientes imágenes, veremos que todas tienes algo en común, utilizan letras blancas (o claras) sobre un fondo negro.


By Ilya - screenshot making, JetBrains - IDEA Community edition interface [Apache License 2.0] via Wikimedia Commons
By Visual Studio Code: Microsoft Sample code: Mr. Stradivarius (talk · contribs) and Toohool (talk · contribs) Screenshot: Codename Lisa (talk · contribs) [MIT] via Wikimedia Commons
By ZxxZxxZ (Own work) [GPL] via Wikimedia Commons

By Sean Haas (http://code.google.com/p/dreckig-os/) [GPL], via Wikimedia Commons

La diferencia es que unas  tienen unos 30 o 40 años y otras son de este año. 
Hace años, cuando la única posibilidad de visualización eran las primeras pantallas C.R.T.  con fósforo verde, no quedaba más remedio que utilizar letras claras sobre fondo negro (salvo que se quisiera quemar la pantalla y los ojos del usuario).
Sin embargo con el tiempo los colores se fueron aclarando e invirtiendo y hace mucho que lo habitual en los ordenadores es usar letras oscuras (negras) sobre fondo claro (blanco) no solo en los interfaces de sistema (como el explorador de archivos) sino en general en los distintos programas (como los paquetes ofimáticos, herramientas de desarrollo, etc.). Incluso los programas de CAD, que tradicionalmente utilizaban líneas blancas sobre fondo negro, se han ido pasando al uso de fondo claro y línea negra (véase por ejemplo Rhinoceros, aunque clásicos como Autocad se mantengan “irreductibles”).

De los pocos elementos que se han mantenido con ese mismo interfaz (e incluso con las mismas funciones) desde hace 30 años son los shells/intérpretes de comandos para los diferentes sistemas operativos, que han mantenido en general su interfaz de fondo negro y letra clara (con excepciones como algunos emuladores de terminal o XTerm de X-Windows). También puede verse estos tonos oscuros en los proyectos trabajando en COBOL y JCL sobre entornos mainframe.

Uno de los motivos que se ha argumentado tradicionalmente para este cambio es que, cuando se trabaja en un entorno iluminado, como es una oficina o una casa particular, el cambio entre un área luminosa (como es el entorno) y un área oscura (la pantalla) cansa la vista al obligar a ajustar la pupila a la distinta luminosidad. Este mismo efecto de deslumbramiento/cansancio se produce por la noche si se está en un entorno oscuro y se utiliza una pantalla clara (fondo blanco y letra negra), por ello se suele recomendar por la noche ese modo “invertido”. Un ejemplo extremo de esto son las herramientas y programas de observación astronómica (como Skymap o Stellarium)), muchas de las cuales tienen un modo “nocturno” que suele utilizar fondo negro y líneas y texto en rojo, para no deslumbrar cuando se utiliza en absoluta oscuridad.

El hecho es que durante muchos años, para editar un documento o una hoja de cálculo, editar un texto, modelar un proceso o programar en un entorno de desarrollo integrado (IDE), siempre se trabajaba con letras oscuras sobre fondo blanco.

Sin embargo desde hace uno o dos años se han ido extendiendo “las tinieblas” ☺ y es más habitual ver pantallas oscuras, sobre todo entornos de desarrollo como IntelliJ IDEA  o Visual Studio Code. Yo incluso lo he visto usar en programas para editar ficheros de texto (de los habituales para editar grandes ficheros, script o fuentes de programas, sin llegar a abrir un IDE completo). Incluso hay extensiones para utilizar esos temas y colores en otros IDE como Netbeans, que tradicionalmente han mantenido colores claros. 

Hay otro contexto donde es habitual ver esta “oscuridad”, es el uso del sistema de virtualización Docker. Este sistema de virtualización está basado en Linux, y aunque existe una versión para trabajar en Windows, lo hace ejecutando una máquina virtual Linux bajo Windows utilizando el sistema de virtualización VirtualBox. El resultado es que es muy habitual ver intérpretes de línea de ordenes Linux incluso en equipos Windows, para gestionar y arrancar las pequeñas (incluso de 50M) “máquinas virtuales” de Docker.

Dado que el ojo humano no ha cambiado, que para editar documentos se sigue manteniendo el negro sobre blanco, al igual que para los libros (electrónicos o en papel) o en muchos otras herramientas que requieren fijar la vista y concentración durante mucho tiempo, hay que concluir que es una moda específica del mundo de desarrollo.

¿Qué motivos puede tener esa moda para extenderse tanto en el ámbito del desarrollo?

Si tenemos en cuenta que Docker es de una alternativa muy moderna y de futuro, que el desarrollo en Android produce muchos más programas, y en ocasiones más originales y atractivos que el desarrollo para ordenadores de sobremesa y que se trata de entornos y herramientas aparecidos recientemente, parece inevitable concluir que el “lucir” una pantalla oscura, aunque solo sea para editar un fichero XML, muestra ante los compañeros y jefes “que estamos a la moda” y trabajando con las últimas tecnologías.

Lo que hace unos años podía ser símbolo de antigüedad y obsolescencia al observar a alguien trabajando con una pantalla oscura (“fíjate, pobres, trabajan en un terminal con lenguajes anticuados como COBOL”) se ha convertido en símbolo de “distinción” (“fíjate, están trabajando con las herramientas más avanzadas”). Aunque se trata de herramientas, mas sofisticadas que un martillo o llave inglesa pero herramientas al fin y al cabo, de nuevo los colores y estilos de moda como símbolo de distinción y estatus.

Esperemos que los creadores de herramientas, y sobre todo los usuarios de las mismas, “vean la luz” ☺ y esta ola de oscuridad se disipe. 
Yo desde luego seguiré trabajando con un entorno claro.

By Moriline (Own work) [CC BY-SA 3.0], via Wikimedia Commons

domingo, 25 de junio de 2017

Lo pequeño es hermoso


“Lo pequeño es hermoso” es el título de un libro publicado en 1973 por F Schumacher. Su nombre completo es “Lo pequeño es hermoso: Economía como si la gente importara” y defiende el uso adecuado de los recursos, procurando utilizar opciones sencillas y recursos lo más limitados posibles.
Este criterio, que siempre ha sido válido, se hace cada vez más necesario en el mundo de la tecnología. Parafraseando el título, podría decirse “Lo pequeño es hermoso: TECNOLOGÍA como si la gente importara”.
Si observamos la tecnología que utilizamos habitualmente, veremos que las páginas Web aumentan cada año su tamaño (peso) medio ( http://httparchive.org/index.php ), de forma que aunque las comunicaciones han mejorado mucho y el ancho de banda disponible para descargar una página se ha multiplicado por 1000 en 20 años, el tiempo de espera en algunos casos es el mismo que cuando se utilizaba un modem a 33k.
Algo equivalente puede decirse de las aplicaciones. La mayoría de los móviles actuales, y desde luego cualquier ordenador, tiene mucha más potencia, memoria y velocidad que ordenadores de hace 20 o 30 años (recordemos que una memoria RAM de 4 megas y un disco de 200 Megas eran “un buen equipo”, por no hablar del PC inicial, con 640K y un disco de 10M). Sin embargo, muchas aplicaciones que utilizamos no parece que vayan mucho más rápidas que hace años, e incluso algunas van más lentas claramente. Además, muchas tienen unos tamaños “monstruosos” para lo (poco) que hacen.
En algunos casos se puede decir que las aplicaciones modernas “hacen más” (se revisa la ortografía y gramática en tiempo real, se presentan gráficos de diverso tipo, se ubica la posición y se hacen cálculos en base a la misma, etc.) pero no tanto para justificar esos rendimientos.
Creo que hay varios motivos que podemos agrupar en personales y tecnológicos:

Personales:
Uno importante sería la despreocupación de algunos desarrolladores (“ahora los equipos son rápidos”, “hay memoria suficiente”, “Todo el mundo tiene mucho ancho de banda”), que provoca que no se intente optimizar el código, ahorrar memoria o ahorrar ancho de banda. 
A ello se une la falta de programadores con experiencia, que es otro factor importante. Programadores veteranos que han aprendido trabajando con ordenadores y herramientas con pocos recursos se han acostumbrado a optimizar y ser ahorradores y tienden a diseñar los programas de forma “austera”.  
Si a eso se añade la necesidad de cumplir los plazos y las especificaciones, no de cumplirlas “óptimamente”, se comprende que en muchos casos la eficiencia queda en último lugar.

Tecnológicos:
Muchos de los lenguajes de programación se “encargan de gestionar la memoria” (como ocurre con java) un desarrollador, aunque sepa con total seguridad que ya no necesita un elemento, no puede borrarlo y debe esperar a que “se borre cuando se pueda”. No bastante creo que el principal motivo son la “herramientas de ayuda al desarrollo”, entre las que podríamos incluir el uso de diversas librerías, framework de desarrollo y herramientas para generación de código. Dado que los lenguajes y herramientas de programación no incluyen todas las funciones posibles para todas las necesidades, se suele acudir a librerías de funciones que contiene diversas funciones (manejo de sonido, imágenes, cálculo, gráficos, etc.) que permiten realizar operaciones sin tener que desarrollar desde cero ese código. El problema es que en muchos casos, el utilizar unas pocas funciones implica arrastrar toda la librería de funciones completa. Es decir, necesitamos, por ejemplo convertir una imagen de formato, o recortarla, pero las librerías incluyen funciones para todos los formatos, para girar, recortar, alterar el color, etc.
Con los framework de desarrollo, que a diferencia de las librerías no ofrecen conjuntos de funciones sino esqueletos de desarrollo sobre los que se encaja nuestro proyecto, pasa algo similar. Están planteados para un modelo de trabajo con una serie de relaciones y comportamientos, de los cuales es posible que muchos elementos sobren para el programa que se desea desarrollar. De nuevo se arrastra una enorme estructura y cimientos planteados para un edificio de 5 plantas cuando lo que se desea una casa unifamiliar (o quizá una casa de 5 plantas pero con otra distribución).
Por último, hay muchas herramientas que para facilitar la vida, permiten generar código fuente. pero ese generación, aunque cómoda, al ser genérica no siempre suele ser demasiado eficaz, con lo que se gana en velocidad de desarrollo (y en ocasiones en calidad y normalización) no se gana (o se pierde) en eficiencia.
El resultado es que con bastante frecuencia tenemos una gran cantidad de programas de dimensiones desmesuradas, peleando por los recursos y consumiéndolos inútilmente. Al igual que ocurre con la contaminación, la emisión de un coche no es demasiado significativa, la de miles, sí. Y todos sufrimos ese exceso de consumo de recursos sufriendo programas lentos y enormes. La memoria, o el ancho de banda de comunicaciones, al igual que los recursos naturales, no son infinitos y es mejor usarlos razonablemente.
Los anglosajones utilizan la expresión “Keep It Simple, Stupid” (K.I.S.S.: "Mantenlo simple, estúpido") también expresada como : “Keep It Short and Simple” ("Mantenlo corto y simple") o “Keep It Simple and Safe” ("Mantenlo simple y seguro") que puede considerarse una especie de Navaja de Occam,  pero aplicada, no al análisis o interpretación, sino al diseño y construcción.

Ejemplos prácticos:
Habrá quien piense que esto es algo teórico y que un programa “serio” necesariamente es grande y complejo. Para demostrar que es posible voy a citar algunos ejemplos:
  • Base de datos: HSQLDB es un gestor de base de datos Open Source que además de cumplir todos los requerimientos de una BBDD relacional y ser extremadamente rápida (http://www.h2database.com/html/performance.html), incluye las siguientes funciones:
    • java puro que funciona en cualquier sistema operativo
    • Emula funciones y sintaxis de otras bases de datos
    • Puede trabajar como base de datos en memoria
    • Puede configurarse para trabajar de modo portable
    • Un fichero jar de 1,5 M incluye el servidor de BBDD, el cliente JDBC y un interfaz de usuario gráfico. 
  • Servidores de aplicaciones: Jetty es un servidor de aplicaciones Open Source similar a Tomcat que cumple todas las funciones necesarias como cualuier otro (https://en.wikipedia.org/wiki/Comparison_of_web_server_software) (quizá solo se echa en falta un interfaz de administración avanzado) y que ocupa unos 11M completo (aunque puede embeberse y utilizarse solo el núcleo del servidor empleando prácticamente un tercio).
  • Motor de indexación por texto completo: El proyecto Open Source Lucene es el motor de indexación y búsqueda por texto completo más utilizado en el mundo, tanto directamente como a través de recubrimientos como Solr o ElasticSearch. Su núcleo, que permite indexar y buscar, ocupa solo 5M.
  • Gestor Documental: OpenProdoc es un gestor documental Open Source completo que incluye todas las funciones de cualquier gestor documental, junto con un gestor de tesauros. Dispone de una versión portable, que gracias al uso de las tres herramientas antes citadas, así como a seguir el principio KISS, ocupa 80M completo, lo que para un gestor documental, teniendo en cuenta que incluye servidor de BBDD, servidor de aplicaciones más el propio Gestor, es poco comparado con algunos clientes de gestor documental que ocupan 700M, o instalaciones de servidor de 1G
  • Utilidades Android: El programa Army Knife, contiene en 2,3M las siguientes herramientas:
    • Calculadora científica
    • Linterna
    • Conversor de unidades,
    • Temporizador/cuenta atrás
    • Cronómetro multi-vueltas
    • Brújula
    • Nivel
    • Lupa
    • Espejo
    • Regla (cm/pulgadas)
  • Gestión de imágenes: El programa Irfanview en solo 2M incluye visualización de prácticamente todos los formatos de imágenes existentes, conversión de formatos, manipulación completa de imágenes (profundidad de color, resolución, filtros, etc.), procesos de conversión en lotes, creación de miniaturas, etc.

Colibrí Mdf [GFDL (http://www.gnu.org/copyleft/fdl.html) CC-BY-SA-3.0


La conclusión es que “sí se puede”, por tanto creo que es importante que como usuarios o como desarrolladores o diseñadores sigamos el principio de : “Lo pequeño es hermoso: TECNOLOGÍA como si la gente importara” a la hora de crear herramientas o de utilizarlas. El "medio ambiente tecnológico" y nuestro paciencia o nervios lo agradecerán.

sábado, 10 de junio de 2017

El altísimo coste del “ahorro” en ordenadores y equipamiento.

Hace años, en un proyecto de gestión documental que estuve desarrollando para un cliente, se instaló el servidor en mi portátil, de forma que las 5 personas del equipo que yo dirigía se conectaban al mismo, desarrollaban y probaban contra él. Exactamente dos días DESPUÉS de acabar el proyecto se quemó el cargador de mi portátil. Cuando fui a la sede de la empresa en que trabajaba para solicitar un cambio, recogieron el antiguo y me indicaron que “ya me avisarían”, pues la norma era no tener recambios. Tres días después, en los que no puede prácticamente trabajar, revisar correo, etc. pude ir a recoger el cargador.
By Evan-Amos (Own work) [Public domain], via Wikimedia Commons

Haciendo una pequeña evaluación del impacto económico:
  • Coste de una fuente de alimentación media: 20€
  • Coste aproximado perdido por 3 días (asumiendo un salario medio bruto + costes empresa SS,..): (44.000 €/220 días trabajo)*3 días = 600€ por tres días de una persona
  • Si la avería se hubiera producido una semana antes: 600€* 6 personas =3.600€
La conclusión de la historia es que por no tener inmovilizados, no ya gastados (salvo que nunca se rompa ningún cargador de ningún empleado) 20€, se perdieron 600€ y se podían haber perdido 3.600€.
Las cifras pueden parecer exageradas pero no lo son en absoluto, y eso solo contando “costes”. Si esas personas estuvieran en una asistencia técnica como consultores, facturando al cliente, por ejemplo 50€/hora, hablaríamos de:
  • 50€*8h/día*3 días*6 personas = 7.200€ que no podrían facturarse (o podría hacerse “engañando” al cliente)
Tampoco se incluye “costes de oportunidad”, cumplimiento de plazos, posibles penalizaciones, impacto en otros equipos, etc.
“Por un clavo se perdió una herradura, por una herradura se perdió un caballo, por un caballo se perdió una batalla, por una batalla se perdió un reino”
Puede alegarse que sin equipo se puede trabajar “en otras cosas”, pero en gran parte de las empresas actualmente, sin ordenador puede hacerse pocas cosas. El correo está en el ordenador, las herramientas de trabajo están en el ordenador, la documentación está en el ordenador, ….
Lo lamentable es que esto no es una anécdota, es un mal muy extendido.
Un extraño sentido de “ahorro” provoca que en muchas empresas de tecnología (y de muchos otros tipos) no haya habitualmente recambios, ordenadores de repuesto o que, desde que se incorpora un empleado a la empresa hasta que se le suministra el ordenador pueda pasar 1 semana (o hasta dos semanas).
Dado que en la mayoría de las empresas las compras de equipos suelen estar normalizadas y se compra una cierta cantidad de ordenadores de la misma marca y modelo, parece razonable pedir una serie de cargadores adicionales, válidos para todos (o casi) todos los equipos, de forma que, ante cualquier avería, en menos de un minuto se remplace el elemento averiado si perder ni un minuto. Según la calidad estimada de los equipos comprados, quizá un cargador adicional por cada 10 o 20 equipos. En el peor de los casos, suponiendo que nunca se estropee ninguno, se habrá gastado un poco de dinero, en el mejor, se habrá ahorrado miles de euros a la empresa.
Pero aún se puede ir “más lejos” en cuanto a evitar pérdidas de tiempo con una pequeña inversión. A raíz del incidente que citaba inicialmente, recuerdo que un compañero me comentó que en su empresa anterior, se entregaban AUTOMÁTICAMENTE, con cada portátil, DOS cargadores. De forma que uno se dejara fijo en la oficina y otro estuviera siempre en el maletín del portátil. Esto ahorra:
  • el estar colocando y recogiendo el cargador cada vez que se llega a la oficina,
  • el riesgo de olvidar el cargador y solo poder trabajar 2 horas fuera (en cliente, reuniones,   guardias o incidencias),
  • por supuesto las posibles averías del cargador, etc.
Simplemente 1 minuto diario de ahorro para conectar el cargador implicaría 220 minutos/año lo que amortiza sobradamente los 20€, sin contar el resto de factores, que no son en absoluto desdeñables.
Esto ocurre con un elemento aparentemente menor y trivial. Si pensamos en el ordenador de trabajo, el efecto es mucho mayor. Suele darse dos “ahorros” habituales:
  1. No tener equipos disponibles de reserva, tanto para las nuevas incorporaciones como para posible averías
  2. Tener equipos poco potentes.
En cuanto a no tener equipos de reserva ya preparados e instalados con las aplicaciones licenciadas y habituales de la empresa, tanto para entregarlos a los nuevos empleados como para dar un equipo temporal de sustitución, es un mal muy extendido. Conozco empresas donde se tarda en entregar el nuevo equipo una semana y hasta un mes. De nuevo aplicando los cálculos anteriores, contando con 200€/día * 5 días, se pierden 1.000€ /semana y 4.000€/mes. De nuevo sin contar otros costes como impacto en otras personas, retrasos, mala imagen, descontento del empleado,... Estas pérdidas aplicarían tanto a los casos en que no se tiene un equipo preparado para los nuevos empleados como los casos de averías.
Respecto al ahorro en la compra de los equipos, tiende a comprarse equipos “económicos“ para todos los empleados, y, aunque esto puede ser válido para los que solo realizan tareas ofimáticas, no lo es para una gran parte de las tareas habituales hoy en día, desarrollo, diseño, edición, calculo, administración, etc. Por ejemplo programando aplicaciones es necesario compilar con mucha frecuencia, instalar servidores de aplicaciones o de bases de datos en el ordenador personal, arrancar un simulador de móvil, etc. Son tareas que llevan mucho tiempo, requieren ordenadores potentes y que en muchos casos obligan al usuario a esperar en diversas tareas (compilación, despliegue, realizar pruebas automáticas, etc.)
Un equipo que permita trabajar un 1% más rápido (algo no muy difícil: CPU Benchmark, Disco duro vs Disco de estado solido) implica ganar/ahorrar 2 días/año, es decir 400€. Con una amortización de 3 años implica 1.200€. Es decir una ganancia de solo un 1% justificaría gastar 1.200€ mas, y desde luego esa no es la diferencia de precio entre equipos con un 1% más de potencia.
Por shigeru23 [GFDL (http://www.gnu.org/copyleft/fdl.html) undefined CC BY-SA 3.0

Dado que el ahorro que se consigue invirtiendo un poco en recambios y equipos más potentes parece evidente, ¿Por qué no es la norma? (al menos según mi experiencia y la de muchas personas que conozco)
Creo que hay varios motivos:
  • Por una parte hay entidades en las que probablemente no se hacen los cálculos y se piensa, sin más análisis, que “tener unas fuentes de alimentación y unos ordenadores ‘sin usar’ es un derroche, hay que ahorrar y gastar lo menos posible”.
  • Posiblemente hay empresas que esperan que los empleados compensen las carencias de equipamiento con un esfuerzo extra: “Tendrás que trabajar este fin de semana para compensar esos días que has tenido el equipo estropeado”, “Esto tiene que estar en fechas, aunque haya que quedarse a cenar tiene que estar compilado y probado”,.. (lo que a la larga tiene otro coste mayor, descontento, pérdida de conocimiento cuando los empleados se “queman” y se van, y mala calidad por las prisas e imposibilidad de probar para entregar a tiempo).
  • Por último, creo que hay otro motivo, debido a la conversión de muchas instituciones en “reinos de taifas”, ya sea por el modelo organizativo y contable simplemente o porque determinados servicios se contraten a una empresa externa. Si un departamento tiene que dar un servicio (como ofrecer equipos informáticos) y únicamente se evalúa como criterio los costes de ese departamento, evidentemente cuanto menos gaste y menos tenga inmovilizado, tanto en potencia como en recambios, mejor. Si a ese departamento no se le aplica un acuerdo de nivel de servicio (S.L.A.) adecuado, que implique por ejemplo que ningún empleado podrá estar sin equipo más de dos horas, o que un proceso normal de trabajo (compilación, diseño, etc.) debe realizarse en menos de un tiempo X, lógicamente se está potenciando el ahorro y considerando como “eficaz” ese departamento, a costa de penalizar a los demás departamentos de la entidad.